群发资讯网

黑贵侃侃科技的文章

「GPT-6 Astra 控制机械臂成功率 95%」是真的,但它只是那张表的第一行。 独立评测方 RoboCurve 9 月 4 日公开的同一批 120 次实验里:把积木放进碗,Astra 19/20,Fable 5.1 8/20;把拼图块插进凹槽,Astra 2/20,Fable 5.1 也是 2/20。每格只有 20 次,难题上看不出谁更强。 真正的差距在 token: ​
「GPT-6 Astra 控制机械臂成功率 95%」是真的,但它只是那张表的第一行。 独立评测方 RoboCurve 9 月 4 日公开的同一批 120 次实验里:把积木放进碗,Astra 19/20,Fable 5.1 8/20;把拼图块插进凹槽,Astra 2/20,Fable 5.1 也是 2/20。每格只有 20 次,难题上看不出谁更强。 真正的差距在 token: ​
Google 10 月 28 日发布 Gemini 4 Carbon,AA 智能指数 v5 得 59 分排第一(中位数 38),但只通过 Fairwind 先发给一小批网络防守方。$2 / $10 是开业价,官方说了会回到 $4 / $20,不是「无结束日期的折扣」。 三天前 Anthropic 前沿红队公开:未发布的内研模型把 Chrome / Safari / Android / Wind ​

Google 10 月 28 日发布 Gemini 4 Carbon,AA 智能指数 v5 得 59 分排第一(中位数 38),但只通过 Fairwind 先发给一小批网络防守方。$2 / $10 是开业价,官方说了会回到 $4 / $20,不是「无结束日期的折扣」。 三天前 Anthropic 前沿红队公开:未发布的内研模型把 Chrome / Safari / Android / Wind ​

有限单群分类定理大概是史上最长的证明:500 多篇论文、约 15000 页、约 100 位数学家。Axiom Math 用几十个 AI agent 跑了 24 天,把它翻成了 4310 万行 Lean 代码,205 万条声明,100 个里程碑。 先纠两个被二传放大的数:AINews 写「约 5000 万行」「数百处勘误」,官方是 43.1M 行、34 处偏差,Ax ​

有限单群分类定理大概是史上最长的证明:500 多篇论文、约 15000 页、约 100 位数学家。Axiom Math 用几十个 AI agent 跑了 24 天,把它翻成了 4310 万行 Lean 代码,205 万条声明,100 个里程碑。 先纠两个被二传放大的数:AINews 写「约 5000 万行」「数百处勘误」,官方是 43.1M 行、34 处偏差,Ax ​

OpenAI 本周发布 GPT-6.1 Terra:输入 $1、输出 $5(每百万 token),约为前代 GPT-5.6 Terra($2/$12)的一半、旗舰 GPT-6 Astra($10/$50)的十分之一,宣传重点却是「接近旗舰」。 同一张 Terminal-Bench 4.0:OpenAI 自报 21.5%→50.3%;AINews 转述 AA 说「涨约 20 分」;AA 模型页正文没给单项 ​

OpenAI 本周发布 GPT-6.1 Terra:输入 $1、输出 $5(每百万 token),约为前代 GPT-5.6 Terra($2/$12)的一半、旗舰 GPT-6 Astra($10/$50)的十分之一,宣传重点却是「接近旗舰」。 同一张 Terminal-Bench 4.0:OpenAI 自报 21.5%→50.3%;AINews 转述 AA 说「涨约 20 分」;AA 模型页正文没给单项 ​
——Apple/苹果 手机——
10699亓 Apple/苹果 勃艮第酒红色手机 256GB
满3000减300领券:
抢购:
可变光圈,续航43小时,2nm 芯片
领红包 更省钱: ​

——Apple/苹果 手机—— 10699亓 Apple/苹果 勃艮第酒红色手机 256GB 满3000减300领券: 抢购: 可变光圈,续航43小时,2nm 芯片 领红包 更省钱: ​

——Apple/苹果 手机—— 10699亓 Apple/苹果 勃艮第酒红色手机 256GB 满3000减300领券: 抢购: 可变光圈,续航43小时,2nm 芯片 领红包 更省钱: ​

它把自己的攻击能力砍掉了 9.5 个百分点,还把这个代价写进了发布说明。 Moonshot 放出 Kimi K3.1 Pro 开放权重前,从中期训练语料和强化学习环境两处删掉了网络攻防数据——砍的是训练本身,不是推理侧拒答。官方原话:不想让开放权重把网络安全能力的绝对前沿再往前推。 内部基准 xdev-bench-hard ​

它把自己的攻击能力砍掉了 9.5 个百分点,还把这个代价写进了发布说明。 Moonshot 放出 Kimi K3.1 Pro 开放权重前,从中期训练语料和强化学习环境两处删掉了网络攻防数据——砍的是训练本身,不是推理侧拒答。官方原话:不想让开放权重把网络安全能力的绝对前沿再往前推。 内部基准 xdev-bench-hard ​

不是漏洞变多了,是以前没人付得起那笔取证费。 PHP 引擎层两个内存安全漏洞(CVE-2026-109618/109619,CVSS 9.2)10 月 20 日披露、21 日补丁就位,一条未认证的 multipart POST 就能触发。修复版:8.5.12、8.4.27、8.3.36、8.2.35,跑 PHP 的赶紧升级;8.2 分支 2026-12-31 就 EOL 了。 注意,不是 ​

不是漏洞变多了,是以前没人付得起那笔取证费。 PHP 引擎层两个内存安全漏洞(CVE-2026-109618/109619,CVSS 9.2)10 月 20 日披露、21 日补丁就位,一条未认证的 multipart POST 就能触发。修复版:8.5.12、8.4.27、8.3.36、8.2.35,跑 PHP 的赶紧升级;8.2 分支 2026-12-31 就 EOL 了。 注意,不是 ​

它把「一张卡一小时赚多少钱」摆上了台面,然后把最值钱的那两块留下了。 DeepSeek 开源了 V4.1-Flash 线上在用的推理框架(Apache 2.0),还公开了一组运营数字:单集群每天吞吐 155 万亿 token,输入缓存命中 96%,平均首 token 400ms,每卡每小时收入 38 美元(谷价)。 撑起这 38 美元的,是 KV ​

它把「一张卡一小时赚多少钱」摆上了台面,然后把最值钱的那两块留下了。 DeepSeek 开源了 V4.1-Flash 线上在用的推理框架(Apache 2.0),还公开了一组运营数字:单集群每天吞吐 155 万亿 token,输入缓存命中 96%,平均首 token 400ms,每卡每小时收入 38 美元(谷价)。 撑起这 38 美元的,是 KV ​
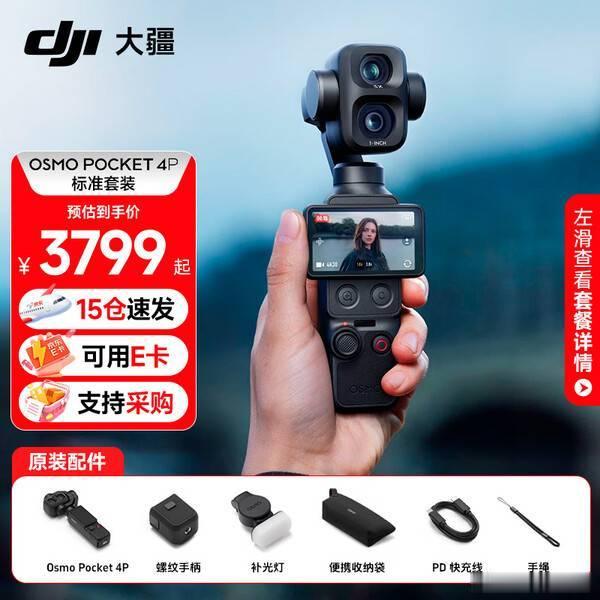
3799亓 大疆(DJI) 双主摄口袋电影机 标准套装
抢购:
大疆年度五星店铺,10w+预约加购,15仓速发
领红包 更省钱: ​

3799亓 大疆(DJI) 双主摄口袋电影机 标准套装 抢购: 大疆年度五星店铺,10w+预约加购,15仓速发 领红包 更省钱: ​

3799亓 大疆(DJI) 双主摄口袋电影机 标准套装 抢购: 大疆年度五星店铺,10w+预约加购,15仓速发 领红包 更省钱: ​

98 分,零突破。 看了一篇 arXiv 论文 TheoPhysEval:约 35 位研究者出了 50 道「未发表」的研究级理论物理题(题是新的,方法是已知的),专家不用 AI 约一天能做完。 GPT-6-Astra 在 Codex 里答对 49 道,98%,平均每题不到 3 美元;Claude Opus 5.5 在 Claude Code 里 92%。断网、不给文献,两者 ​

98 分,零突破。 看了一篇 arXiv 论文 TheoPhysEval:约 35 位研究者出了 50 道「未发表」的研究级理论物理题(题是新的,方法是已知的),专家不用 AI 约一天能做完。 GPT-6-Astra 在 Codex 里答对 49 道,98%,平均每题不到 3 美元;Claude Opus 5.5 在 Claude Code 里 92%。断网、不给文献,两者 ​

几万亿美元的 AI 算力账单,其实落在「折旧」这一栏。 读 Robonomics 的一篇 AI 基建估算(注意:全是作者本人估算,不是官方数据):2027 年全球 AI 算力新增需求约 50–55GW,对应资本开支 2.5–3.0 万亿美元。按 IT 设备 5 年、建筑与电力 15 年折旧,每年要摊约 4,000 亿美元。 而 OpenAI + Anth ​

几万亿美元的 AI 算力账单,其实落在「折旧」这一栏。 读 Robonomics 的一篇 AI 基建估算(注意:全是作者本人估算,不是官方数据):2027 年全球 AI 算力新增需求约 50–55GW,对应资本开支 2.5–3.0 万亿美元。按 IT 设备 5 年、建筑与电力 15 年折旧,每年要摊约 4,000 亿美元。 而 OpenAI + Anth ​

华晨宇就是那种看re0会在弹幕刷“如果真爱有颜色那就一定是蓝色”的那种人,是那种看超电磁炮会大喊“你指尖跃动的电光是我此生不灭的信仰唯我超电磁炮永存”的那种人,是那种看完国家队会给他02叫老婆叫darling的那种人,是那种看完冰菓会换上折棒头像并且把个签改成“我很好奇”的那种人,是那些看完 ​

华晨宇就是那种看re0会在弹幕刷“如果真爱有颜色那就一定是蓝色”的那种人,是那种看超电磁炮会大喊“你指尖跃动的电光是我此生不灭的信仰唯我超电磁炮永存”的那种人,是那种看完国家队会给他02叫老婆叫darling的那种人,是那种看完冰菓会换上折棒头像并且把个签改成“我很好奇”的那种人,是那些看完 ​

卖 agent 的笼子,比卖 agent 更稳。 Modal 宣布年化收入跨过 10 亿美元,完成 7.5 亿美元 D 轮,估值 157.5 亿美元(Accel 领投,以官方口径为准)。用量 5 个月涨 3 倍、一年涨 15 倍。 更有意思的是 Sandboxes:据联创自述(未经独立核实),这个 2023 年才上线的产品,年化收入已约 3 亿美元,三 ​

卖 agent 的笼子,比卖 agent 更稳。 Modal 宣布年化收入跨过 10 亿美元,完成 7.5 亿美元 D 轮,估值 157.5 亿美元(Accel 领投,以官方口径为准)。用量 5 个月涨 3 倍、一年涨 15 倍。 更有意思的是 Sandboxes:据联创自述(未经独立核实),这个 2023 年才上线的产品,年化收入已约 3 亿美元,三 ​
——Apple/苹果 手机——
10699亓 Apple/苹果 银色手机 256GB
满3000减300领券:
抢购:
可变光圈,续航43小时,2nm 芯片 ​

——Apple/苹果 手机—— 10699亓 Apple/苹果 银色手机 256GB 满3000减300领券: 抢购: 可变光圈,续航43小时,2nm 芯片 ​

——Apple/苹果 手机—— 10699亓 Apple/苹果 银色手机 256GB 满3000减300领券: 抢购: 可变光圈,续航43小时,2nm 芯片 ​

分数只差 2 分的是 Wonder Full,不是 Wonder。 Meta 发了 Muse Wonder。按 Artificial Analysis 指数 v4.3:Opus 5.5 58 分居首,Muse Wonder Full 56 分,普通版 Wonder 52 分。Wonder 标价每百万 token $4 输入 / $20 输出,上下文 100 万 token,跑一次整套任务约 $4.52(Opus 5.5 是 $5.98)。 ​

分数只差 2 分的是 Wonder Full,不是 Wonder。 Meta 发了 Muse Wonder。按 Artificial Analysis 指数 v4.3:Opus 5.5 58 分居首,Muse Wonder Full 56 分,普通版 Wonder 52 分。Wonder 标价每百万 token $4 输入 / $20 输出,上下文 100 万 token,跑一次整套任务约 $4.52(Opus 5.5 是 $5.98)。 ​

同一块 GPU,一边给客户跑推理,一边给你挖矿? 两条链在试同一件事:把「烧掉的计算」换成「有人付钱的计算」。Pearl 4 月 27 日上线,挖矿机制 NoisyGEMM,本质就是矩阵乘法,用 Plonky2 出约 60KB 的零知识证明;目前只支持整数矩阵,FP8 还在开发。Together AI 上线了 Gemma-4-31B-it-Pearl,推理 ​

同一块 GPU,一边给客户跑推理,一边给你挖矿? 两条链在试同一件事:把「烧掉的计算」换成「有人付钱的计算」。Pearl 4 月 27 日上线,挖矿机制 NoisyGEMM,本质就是矩阵乘法,用 Plonky2 出约 60KB 的零知识证明;目前只支持整数矩阵,FP8 还在开发。Together AI 上线了 Gemma-4-31B-it-Pearl,推理 ​

模型不再写字,只给答案:决策模型正在变成一个品类。 Jev 不生成文字,只返回带置信度的选项(Choice / Score / Noul),32K 上下文、不聊天、不写代码。价格是每百万输入 token $0.042,输出免费,响应 70–500ms。 三周内大厂全跟上了:OpenAI Decisions API 每百万输入 $0.10、无输出费;Cloudfl ​

模型不再写字,只给答案:决策模型正在变成一个品类。 Jev 不生成文字,只返回带置信度的选项(Choice / Score / Noul),32K 上下文、不聊天、不写代码。价格是每百万输入 token $0.042,输出免费,响应 70–500ms。 三周内大厂全跟上了:OpenAI Decisions API 每百万输入 $0.10、无输出费;Cloudfl ​

「便宜 75%」是话术:Claude Haiku 5.5 的降价账。 围绕它的成本有三种说法:Anthropic 官方说平均便宜 75%,Cursor 说短请求便宜 10 倍,Vals 实测却是每个任务更贵。 不矛盾,量的不是一回事。单价是每百万 tokens 输入 $0.10、输出 $0.50(超过 100K 上下文涨 5 倍);但 max effort 下每个任务约 ​

「便宜 75%」是话术:Claude Haiku 5.5 的降价账。 围绕它的成本有三种说法:Anthropic 官方说平均便宜 75%,Cursor 说短请求便宜 10 倍,Vals 实测却是每个任务更贵。 不矛盾,量的不是一回事。单价是每百万 tokens 输入 $0.10、输出 $0.50(超过 100K 上下文涨 5 倍);但 max effort 下每个任务约 ​

「认知投降」:AI 没让我们更闲,反而更忙了。 《Building Microservices》作者 Sam Newman 在新一期 Pragmatic Engineer 播客里说:现在用 AI 的方式,带来的是更多上下文切换、更少思考时间、更长工时。他还说,LLM 不是世界模型,没有「我做 A,B 就会发生」的因果概念。 巧的是播客上线前一天, ​

「认知投降」:AI 没让我们更闲,反而更忙了。 《Building Microservices》作者 Sam Newman 在新一期 Pragmatic Engineer 播客里说:现在用 AI 的方式,带来的是更多上下文切换、更少思考时间、更长工时。他还说,LLM 不是世界模型,没有「我做 A,B 就会发生」的因果概念。 巧的是播客上线前一天, ​

上个月下旬,牛津哲学家 Toby Ord 拿 OpenAI 公布的 GPT-5.6 Sol 曲线,反算「集群规模」这条缩放轴的系数 λ:BrowseComp 0.68、SEC-Bench Pro 0.57、Terminal-Bench 0.48。 翻译过来:agent 放大 10 倍,性能约只换来 3–5 倍;单体推理 token 放大 10 倍,就是实打实的 10 倍。 他算了笔账:10,00 ​

上个月下旬,牛津哲学家 Toby Ord 拿 OpenAI 公布的 GPT-5.6 Sol 曲线,反算「集群规模」这条缩放轴的系数 λ:BrowseComp 0.68、SEC-Bench Pro 0.57、Terminal-Bench 0.48。 翻译过来:agent 放大 10 倍,性能约只换来 3–5 倍;单体推理 token 放大 10 倍,就是实打实的 10 倍。 他算了笔账:10,00 ​