9 月 30 日,谷歌正式发布了新一代旗舰大模型 Gemini 4 Argon。官方公布的数据显示,它在 18 项基准测试中拿下了 13 项的第一或并列第一,尤其在知识型工作和长上下文推理上优势明显。
但比成绩更值得关注的是发布方式:这款模型没有第一时间向所有开发者开放,而是先交给一批专注网络安全防御的合作伙伴使用。再加上谷歌直接跳过了原本规划中的 Gemini 3.5 Pro,这次发布从节奏到策略都和以往不太一样。
本文按 "成绩 → 能力 → 安全 → 价格 → 背景" 的顺序,把 Gemini 4 Argon 拆开来看,最后也聊聊它对开发者选型的影响。
成绩单:知识工作全面领先,编程互有胜负先看最受关注的基准测试。官方对比的对象是 OpenAI 的 GPT-6 Astra 和 Anthropic 的 Claude Fable 5.1、Claude Opus 5.5。
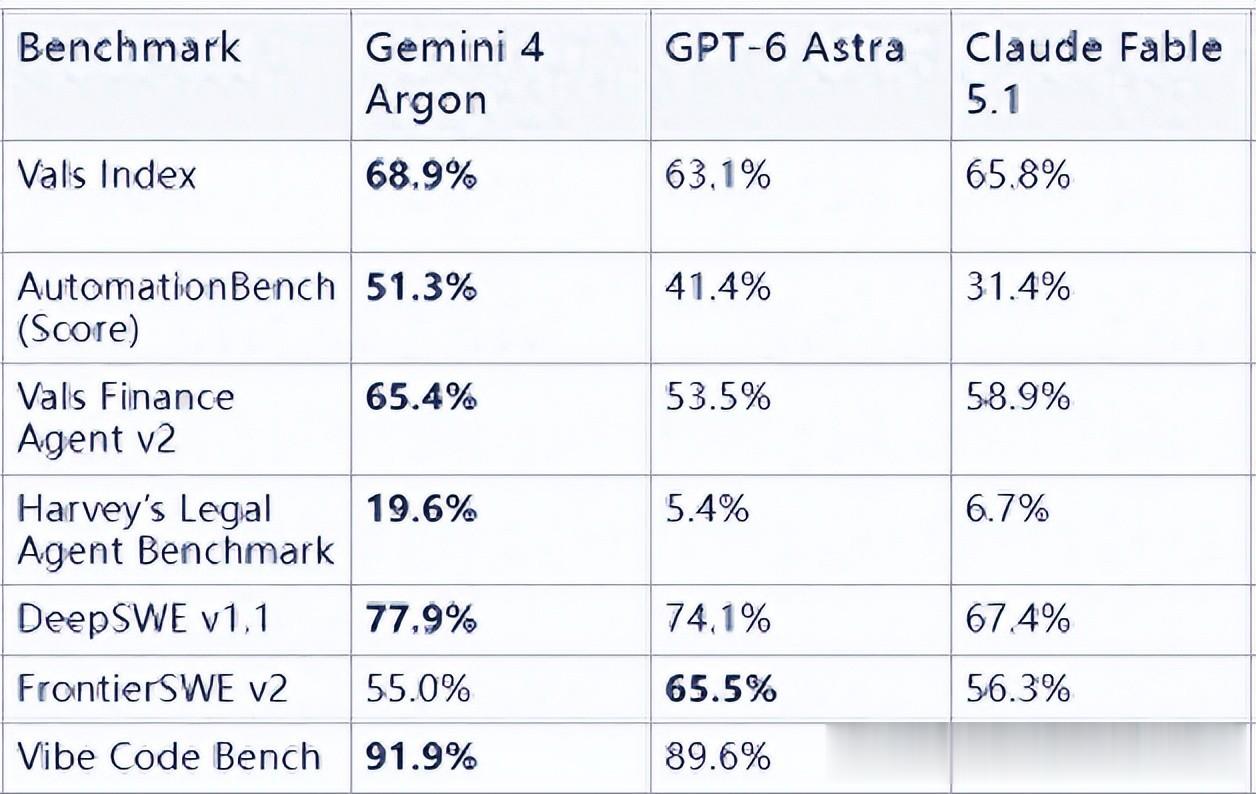
知识型工作:几乎是碾压在偏 "白领工作" 的评测里,Argon 的优势非常明显:
Vals Index:68.9%,领先 Opus 5.5 的 67.0%;Vals Finance Agent v2:65.4%,比 Fable 5.1 高出约 6.5 个百分点;Harvey's Legal Agent Benchmark:19.6%,大约是 Fable 5.1 的三倍。

金融分析、法律检索这类任务的共同特点是:需要在大量材料中定位信息、做多步推理、给出结构化结论。Argon 在这类场景中的领先,与它强调的长上下文推理能力是一致的。
编程能力:有高光,也有短板编程方面的情况就复杂得多:
DeepSWE v1.1:77.9%,位列第一,领先 Astra 和 Opus 约 3~4 个百分点,谷歌称之为该测试的新 SOTA;FrontierSWE v2:55.0%,落后 Astra 的 65.5% 足足 10.5 个百分点;Terminal-bench 4.0:57.4%,落后 Opus 5.5 的 66.4% 近 9 个百分点。

换句话说,在 "给定仓库修复问题" 这类任务上 Argon 很强,但在更开放的前沿工程任务和终端操作类 Agent 任务上,Astra 和 Opus 依然有优势。如果你的主要场景是 Coding Agent、自动化运维这类需要大量命令行交互的工作,现阶段不宜只凭 "总榜第一" 就切换模型。
解读数据时要留个心眼这些对比并不是在完全一致的实验条件下跑出来的。以 DeepSWE 为例,Argon 的分数用的是谷歌自家的 mini-swe agent 框架,而竞品数据来自公开排行榜和各家自报结果。Agent 框架、提示词、重试策略的差异都可能带来几个百分点的波动,所以几个点以内的差距,更适合看作 "同一梯队",而不是绝对的高下。最靠谱的方式,仍然是用自己业务里的真实任务做一轮小规模评测。
技术规格亮点:输出上限从 6.4 万提升到 100 万 TokenArgon 在规格上最大的突破,是把单次输出 Token 上限从 64,000 一口气拉到了 1,000,000。
很多人会把它和 "百万上下文" 混为一谈,但 "能读 100 万" 和 "能写 100 万" 完全不是一个难度:
输入阶段(Prefill):可以高度并行地处理整段文本,算力开销相对可控;输出阶段(Decoding):模型是自回归生成的,每输出一个 Token 都要依赖之前生成的所有内容。要连续生成 100 万个 Token,意味着在极长的时间里保持注意力机制稳定,对显存、KV Cache 优化和硬件带宽都是极大的考验。谷歌把这项能力和深度推理绑定在一起:更大的生成空间,让模型可以在一次运行里完成更长的任务链,而不必频繁拆分、续写、拼接。
内部落地案例谷歌披露的几个内部案例,很好地说明了 "超长输出 + Agent" 能做什么:
数据中心内存优化:Argon 智能体分析集群性能遥测数据并实施优化,已经释放超过 300 TiB 内存,潜在节省规模估计在 500 TiB 到 1 PiB 之间;C/C++ 迁移到 Rust:参与了 re2 等核心库的迁移,以及 Fuchsia 操作系统 Zircon 内核超过 80 万行代码的迁移工程;libgav1 视频解码库:智能体替换了 3.2 万行 SIMD 代码,最终的解码器比此前的 Rust 移植版本快 2.7 倍;量子计算:协助优化了一个子程序的时空资源,改进幅度达到 40%。这些案例有一个共同点:都是规模大、规则明确、可验证的工程任务。这也给企业落地提供了思路 —— 大规模代码迁移、遗留系统重构、批量性能调优,是这类模型最容易产生实际价值的方向。对于使用低代码平台(例如 JeecgBoot)的团队来说,老旧模块的批量升级、代码规范统一、生成代码的大规模审查,同样属于这类 "长链路、可验证" 的任务。
安全优先:为什么先给网络安全团队用近几周,AI 安全问题在科技圈引发了大量讨论。谷歌这次选择了一种相对保守的发布方式:
先防御后开放:模型最初只面向专注网络安全防御的特定企业和组织,等防御方有时间修补系统漏洞、修复模型发现的缺陷之后,再逐步扩大开放范围;内置越界监控:Argon 带有新的安全防护机制,能在模型执行超出用户预期的任务时及时发现,并在越界时终止其行为。Gemini 高级总监兼产品负责人 Tulsee Doshi 表示,从目前观察来看,这些防护措施是有效的。漏洞挖掘能力Argon 经过专项训练,可以自主发现、验证并修补软件漏洞。Fairwind Program 的受信参与方和谷歌内部团队,可以获得不带网络安全护栏的原始模型访问权限。
几个值得关注的数据:
谷歌旗下的 Wiz 已将 Argon 用于 "Scan for Good" 漏洞扫描项目,发现了一个存在于全球多家医院所用医疗软件中的严重漏洞,而此前多款前沿模型都没能识别出这个风险;内部源代码漏洞发现测试中得分 85.8%,高于 Gemini 3.8 Flash Cyber 的 71.0%;Wiz 黑盒渗透测试评估中得分 70.9%,高于后者的 58.2%;公开的 CWE-bench v1 漏洞修复测试中,Argon 以 68.0% 与 GPT-6 Astra 并列,Opus 5.5 以 67.0% 紧随其后。能力越强的漏洞挖掘模型,被滥用时的破坏力也越大。"先让防守方用起来" 这种分阶段开放策略,很可能会成为后续前沿模型发布的常见做法。
定价策略:推广期很香,但别忘了会翻倍Argon 的 API 定价分两个阶段:
推广期:每百万输入 Token 2 美元,每百万输出 Token 10 美元;缓存输入享受 95% 折扣,折算约每百万 Token 0.10 美元;推广期结束后:输入涨到 4 美元、输出涨到 20 美元,均为翻倍。谷歌没有公布推广期的具体截止时间。

横向对比来看:
模型
输入($/ 百万 Token)
输出($/ 百万 Token)
与 Argon 推广期相比
Gemini 4 Argon(推广期)
2
10
—
Gemini 4 Argon(推广期后)
4
20
2 倍
GPT-6 Astra
10
50
5 倍
Claude Fable 5.1
10
50
5 倍
Claude Opus 5.5
4
20
2 倍(与 Argon 推广期后持平)
GPT-6.1 Sol
2
10
持平
Gemini 3.8 Flash
0.75
3.75
更便宜
从表格可以看出,Argon 推广期价格只有 Astra、Fable 5.1 的五分之一,冲击力很强;但性价比市场并不是它一家独占:OpenAI 的 GPT-6.1 Sol 与它推广期价格完全相同,而谷歌自家的 Gemini 3.8 Flash 还要更便宜。由于官方对比中没有纳入 GPT-6.1 Sol,同价位两款模型的真实差距还需要市场来检验。
给开发者的建议:
推广期适合做评估和原型验证,但成本测算要按推广期后的价格来做,避免上线后预算翻倍;充分利用缓存输入的 95% 折扣 —— 系统提示词、知识库片段等固定前缀尽量复用,长对话和 RAG 场景能省下可观的费用;超长输出虽然强大,但输出 Token 单价是输入的 5 倍,按需开启,别让模型 "写得比需要的多"。发布背景:放弃 3.5 Pro,直接押注 Gemini 4Argon 的到来,也意味着谷歌正式放弃了 Gemini 3.5 Pro。
今年 5 月的 I/O 开发者大会上,谷歌曾宣布计划在 6 月推出 Gemini 3.5 Pro,但这一计划始终没有落地,之后只陆续发布了一系列 Flash 模型。AI 评测机构 Vals AI 的分析认为,这说明 3.5 Pro 的性能已不足以追上竞争对手,谷歌干脆跳级发布 Gemini 4,重新争夺前沿位置。
7 月的投资者电话会议上,皮查伊也承认了谷歌暂时落后的局面,但强调 "我们仍在许多维度上保持前沿水平",并把 Gemini 4 视为追赶的关键。回想去年 11 月,谷歌曾凭借一款新模型短暂登顶排行榜,一度让 OpenAI 内部拉响 "红色警报"。这一次 Argon 能否守住反攻成果,要等全面开放之后才能见分晓。
总结综合来看,Gemini 4 Argon 的特点可以概括为四点:
知识工作和长上下文推理处于第一梯队,金融、法律类 Agent 任务优势明显;编程能力并非全面领先,DeepSWE 夺冠,但 FrontierSWE、Terminal-bench 仍落后于竞品,Coding Agent 场景需要自行实测;百万 Token 输出上限是真正的技术突破,为大规模代码迁移、长链路 Agent 任务打开了空间;推广期定价极具竞争力,但涨价是确定的,成本规划要留足余量。对于开发者和企业来说,更务实的做法是:在推广期内用自己的真实业务数据做一轮对比评测,把它当作模型组合中的一个选项,而不是简单地 "谁第一就全量切换"。
本文为 JeecgBoot AI 专题研究系列文章。