ICLR 2026 | LLM过度思考如何减半不掉分
🚀 一道简单题,已经答对,LLM却反复推导,浪费Token。“过度思考”让大模型更耗计算,响应变慢。
📄 该论文《Overthinking Reduction with Decoupled Rewards and Curriculum Data Scheduling》,由Shuyang Jiang、Yusheng Liao、Ya Zhang、Yanfeng Wang、Yu Wang完成,机构包括复旦大学、上海交通大学、上海人工智能实验室。该论文发表于ICLR 2026,提出DECS框架,减少冗余思考,同时保留解题能力。
🔍 痛点:直接惩罚“想太久”为何失效?
传统方法按整段推理长度打分,答对但过程较长,也可能扣分。该论文指出:探索新思路的关键Token会被误罚,削弱有效探索;较短推理里的多余Token却可能获奖。必要推理受损,冗余仍在。
💡 例子:
「老师要求学生解题越简洁越好。学生甲列出关键推导,答对后又检查五遍;学生乙篇幅较短,却也写了废话。如果只按总字数打分,甲的关键推导可能被误伤,乙的废话反而获奖。DECS就像先找出‘足以得出答案’的必要步骤,再扣掉后面的重复内容。」
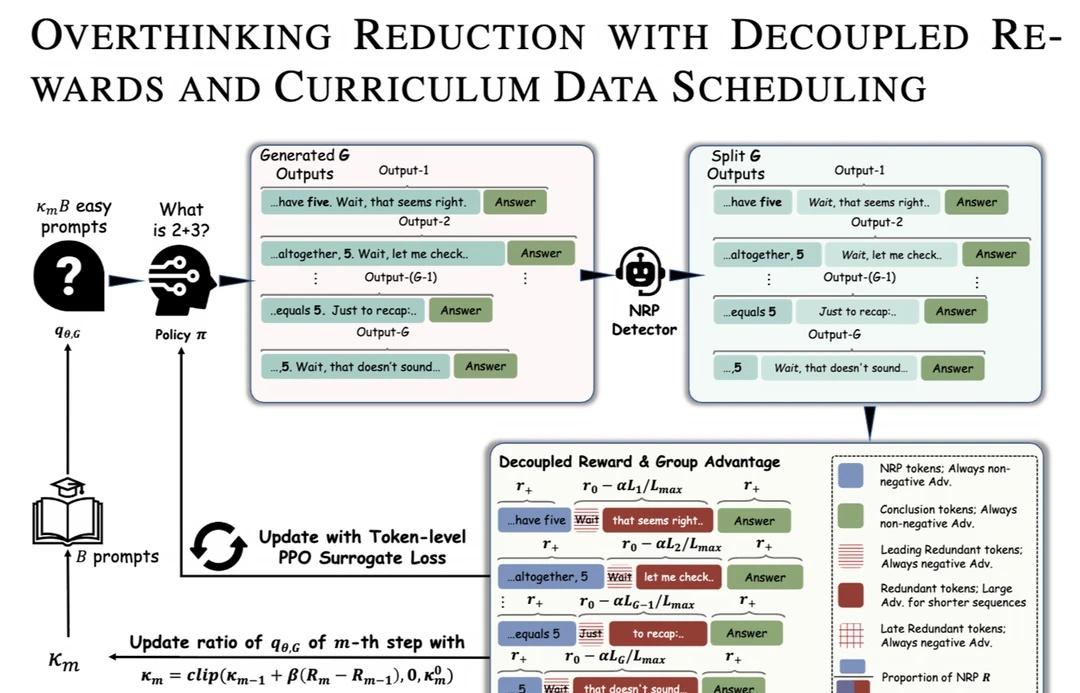
🛠️ 方案:该论文训练轻量级判别模型,将推理拆成片段,定位首次足以支持正确答案的“必要推理前缀”(NRP)。随后采用解耦Token级奖励:保护必要推理与最终答案,惩罚NRP之后的冗余Token。再通过课程式批次调度,调整简单题比例,保护探索能力。
📊 实验发现:
① DeepSeek-R1-Distill-1.5B:平均推理Token减少57.17%,Pass@1准确率提高2.48个百分点。
② 同系列7B模型:Token减少49.50%,准确率提高0.8个百分点。
③ Qwen3-4B:Token减少54.80%,准确率提高1.32个百分点。此外,1.5B模型的Pass@K曲线与原模型几乎重合,说明探索潜力仍在。
✨ 启示:该论文表明,推理提效不是强迫LLM“少想”,而是保护必要思考,精准删除重复。
论文 大语言模型 ai 科研 人工智能 安全 ICLR