“做判断”这件事,正在变得比打印一张A4纸还便宜。
谷歌在同一天抛出了两样东西:旗舰模型Gemini4Carbon面向全球开放,主打复杂编程、科学研究与网络安全。
而真正把桌子掀了的,是一个不起眼的小接口GeminiDecisionsAPI,每百万输入Token只收0.10美元,输出Token直接免费。
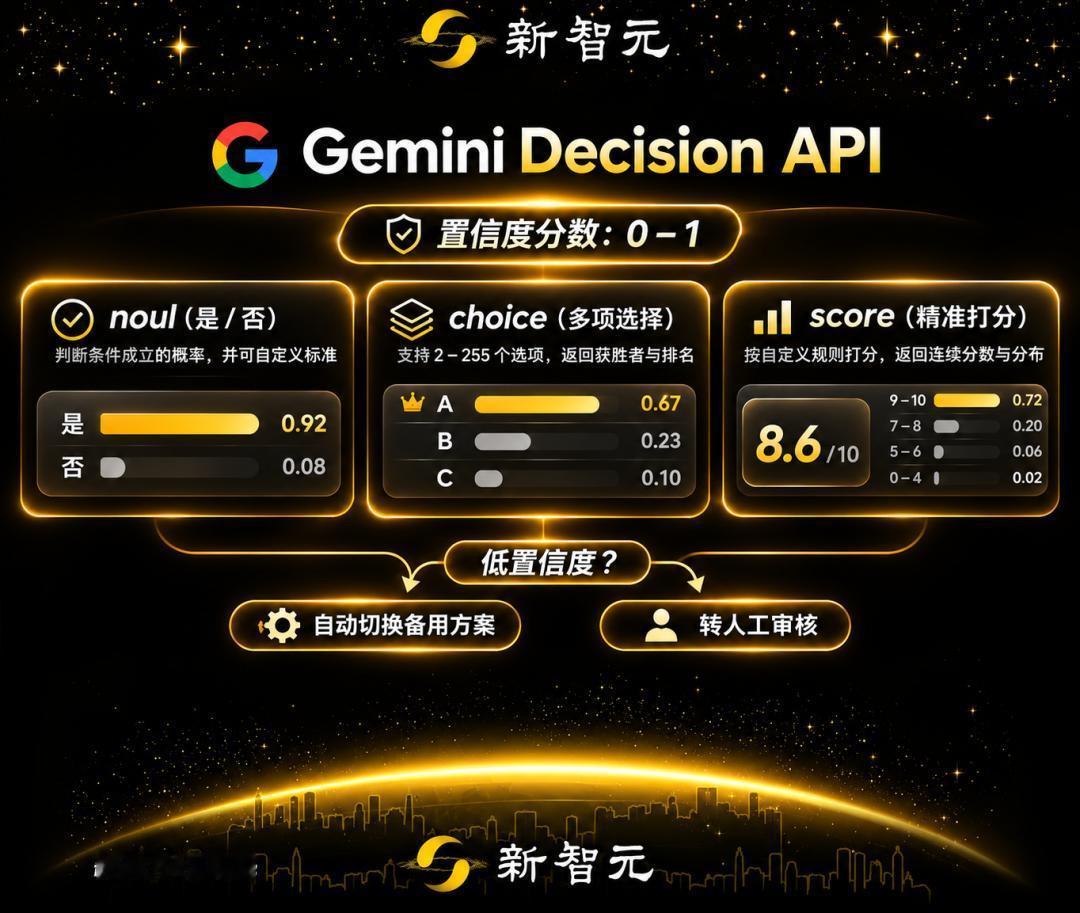
它的底层是GeminiDecision1,不逐字生成任何解释性文字,只做一件事:给你预设好的选项打分,返回概率和置信度。
是非判断、多项选择、有序评分,三种题型可以在一次请求里混着用,单次最多处理1000个独立问题,端到端延迟压在150到250毫秒。
有开发者实测,100个判断问题扔进去,0.41秒出结果。
这条新闻被淹没在“新模型发布”的热闹里,实在太可惜了。
它标记的不是又一次跑分刷新,而是AI产业计价单位的一次静默迁移:过去按生成多少字收费,现在按“做对了几次判断”收费。
当“判断”被从生成式模型里剥离出来、单独标价、单独交付,真正被重新定价的东西,远远超出一个API接口的范畴。
生成式大模型一直在用“写作文”的架势,处理“打勾打叉”的活。
一封邮件是不是垃圾邮件,一个客服工单该进哪个队列,一段内容是否符合安全规则,一张理赔照片该不该转人工这些任务本来只需要一个类别、一个分数、一个是或否。
但传统做法是调用一个通用大模型,让它逐Token生成一段文本,再从文本里把那个早就该直接给出的答案“捞”出来。
GeminiDecision1省掉的正是这个冗余环节:候选选项已经摆在那里,模型通过一次前向传播直接给它们打分,不需要把答案“说”出来。
省掉“说”这一步,带来的连锁反应比想象中剧烈。
延迟从生成式模型的“读一段话的时间”压缩到人类神经反射的量级;输出Token不收费,意味着调用成本几乎只取决于你“喂进去”多少材料,而不取决于模型“吐出来”多少字。
对于需要高频分类、路由、审核、打标的系统来说,账本上的数字会变得非常陌生。
VentureBeat算过一笔简单的账:一份4000Token的文件做20项检查,如果分成20次调用、每次重新发送全文,成本约8.10美元;整合成一次请求,费用降到0.50美元左右。
这种量级的成本塌缩,让过去“因为调用太贵所以只挑几个关键节点做AI判断”的设计逻辑开始松动。
“判断”变便宜之后,首先被挤压的是那些默认由人兜底的决策缝隙。
任何组织里都存在大量微决策:这条告警要不要升级,这张工单要不要标记异常,这个新用户的行为序列像不像机器注册。
它们单次价值极低,低到不值得专门训练一个分类器;但数量极大,大到持续消耗人的注意力。
过去AI处理这类任务性价比不高,生成一段解释的成本可能比人扫一眼还贵。
现在一个判断的边际成本逼近于零,且一次调用可以覆盖1000个独立问题,组织就有条件把过去“算了,让人看一眼吧”的环节,成批地交给机器先过一遍。
谷歌自己的GeminiNotebook已经在用这个接口做模型路由,把简单查询分流到轻量层,日常延迟最多降低40%,把昂贵的推理资源留给真正复杂的请求。
但“判断”的工业化也暴露了一个生成式模型长期掩盖的问题:一个判断之所以有价值,前提是它知道自己什么时候不该下判断。
实测中,GeminiDecision1在54次API调用、30条客服工单和8项多语言任务上全部分类正确,但开发者发现,当输入超出预设类别范围时,模型会“强行归类”。
它会给出一个概率,哪怕正确答案是“以上都不是”。
这不是Gemini一家的缺陷,而是所有封闭选项决策模型的共同软肋:候选集由人划定,模型只负责在候选集里选一个最不坏的。
候选集本身没覆盖到的情况,模型没有能力告诉你“这道题出错了”。
这意味着“判断”变便宜,不会自动带来“判断”变可靠。
它改变的只是成本结构,不改变责任结构。
当企业把越来越多的微决策交给一个每百万Token一毛钱的接口,真正需要重新设计的,是置信度阈值怎么设、什么情况下自动放行、什么情况下必须转人工、候选集谁来维护、边界情况多久审计一次。
谷歌给出的方案是把置信度分数一并返回,让系统自己设门槛。
但门槛设在哪里,仍然是一个人的问题,一个组织的问题。
谷歌Gemini Decisions API上线