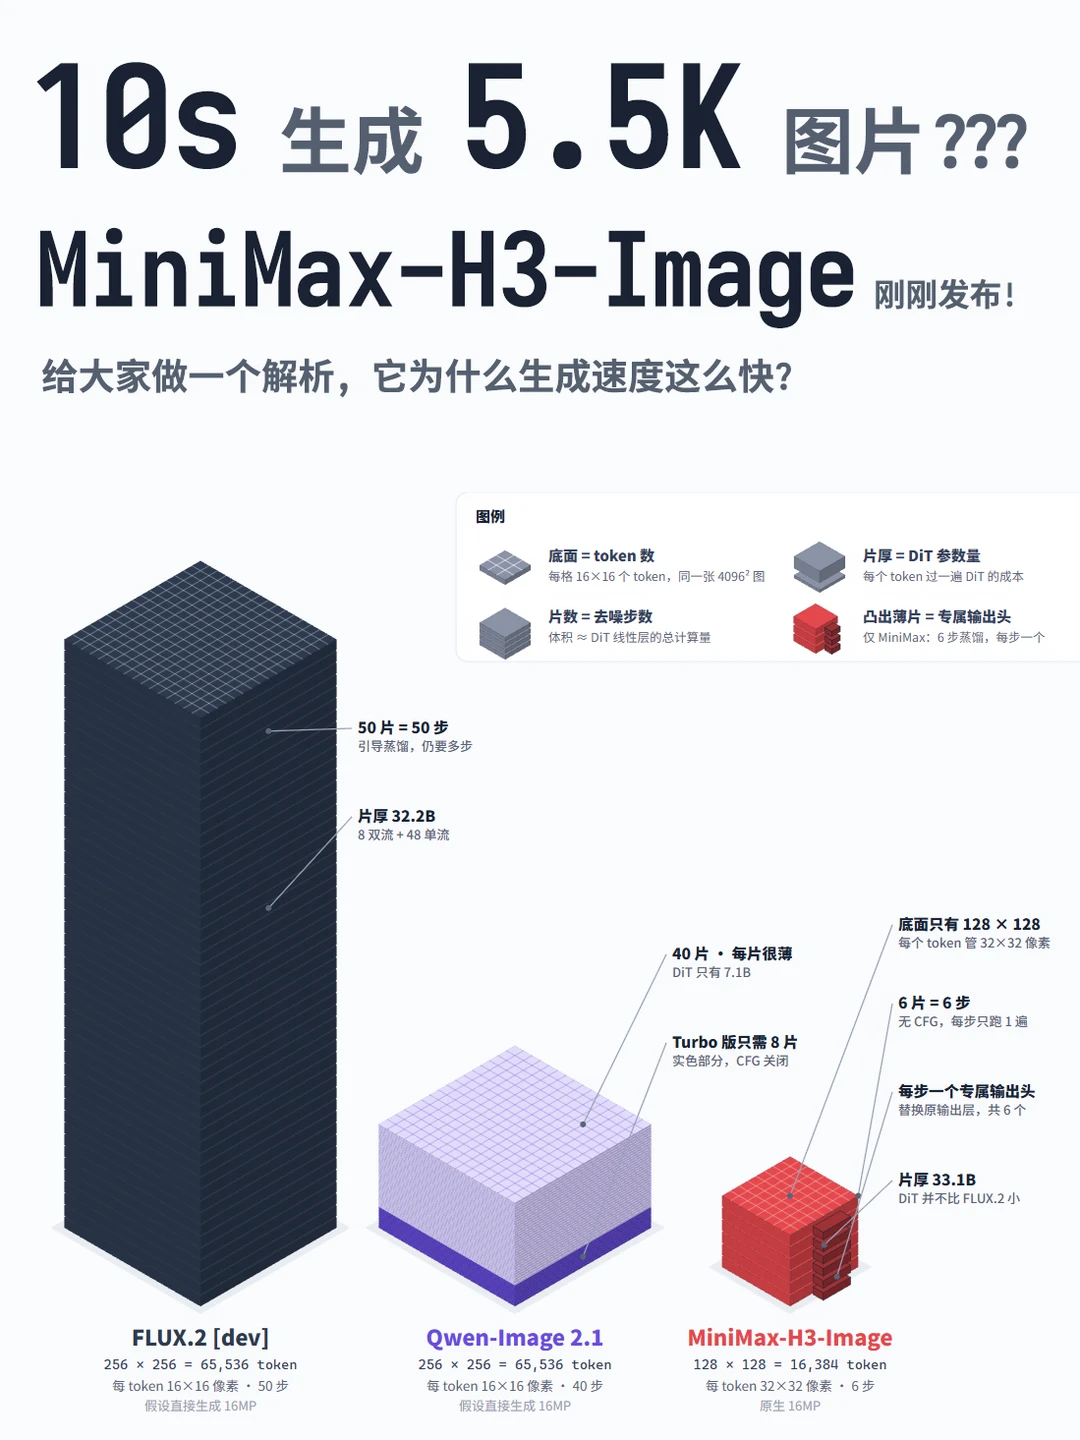
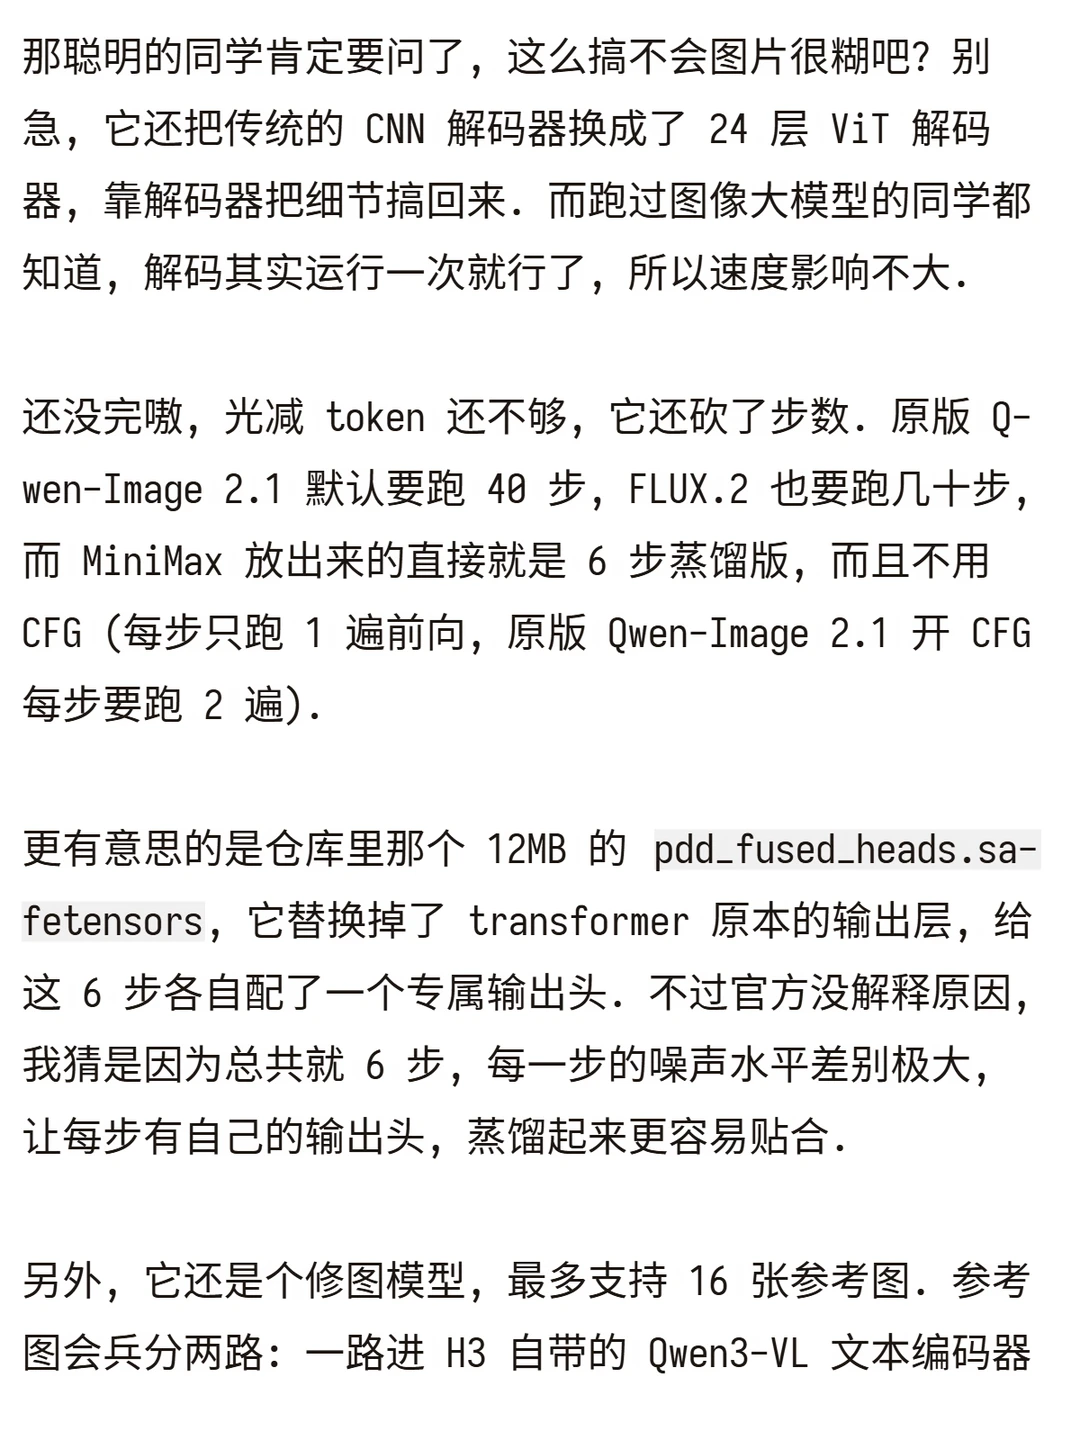
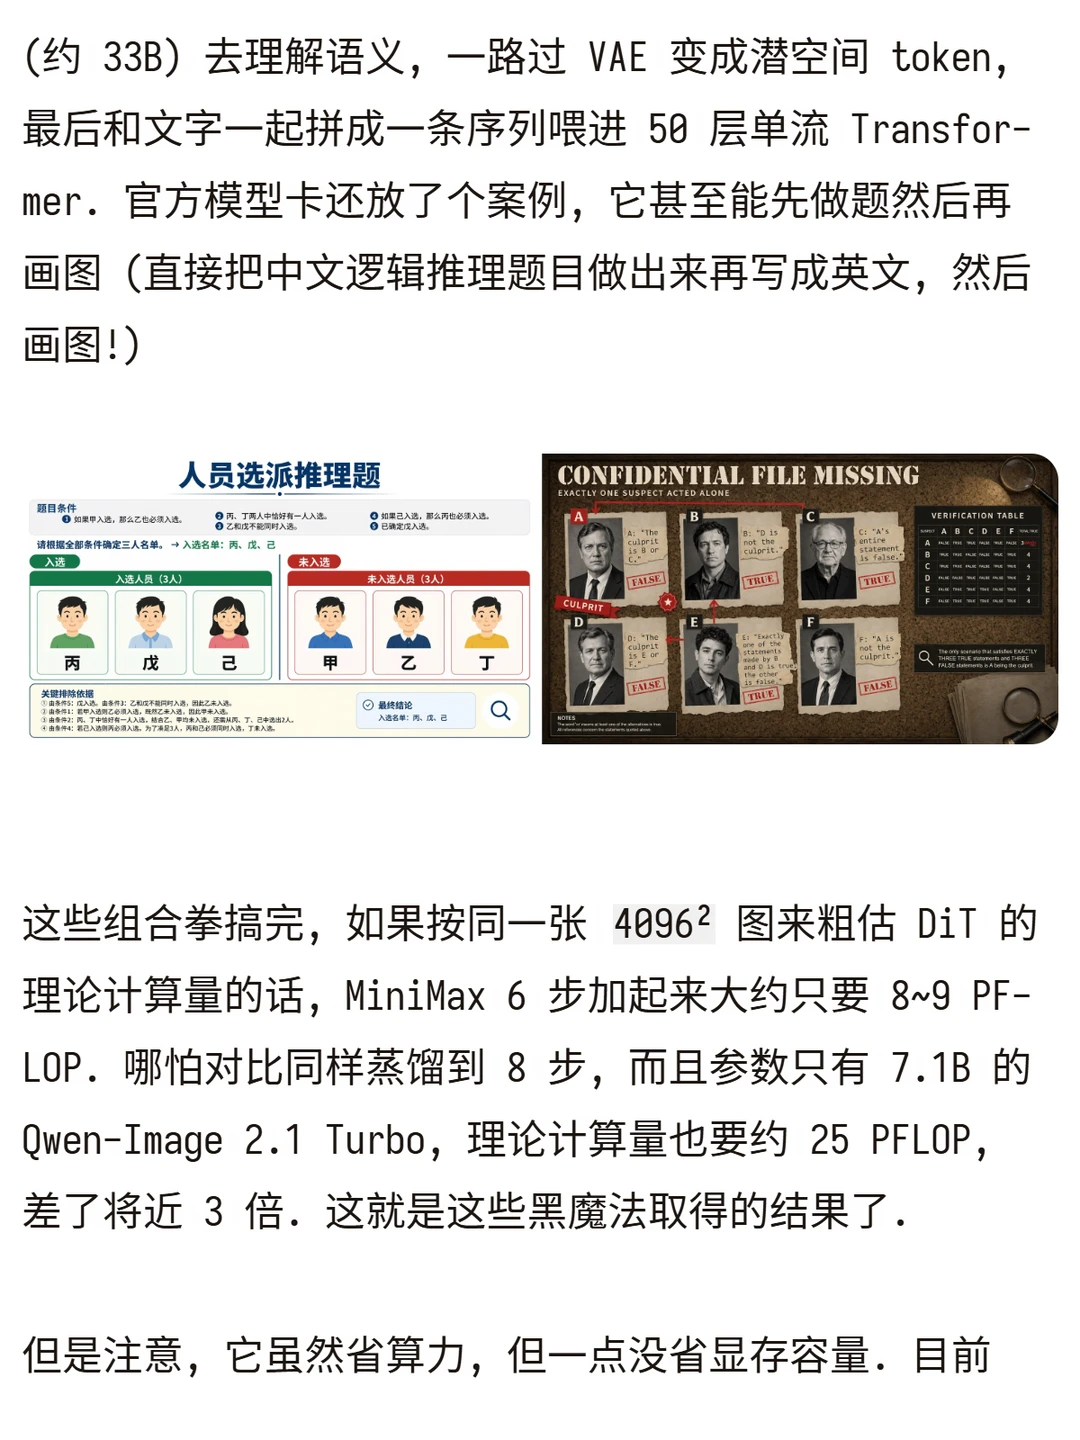
MiniMax-H3-Image 6小时前刚刚发布! 官方直接说原生直出 1600 万像素 (注意这个是原生的哦, 不用ComfyUI走超分辨率放大, 不会丢细节), 并且它文生图和图像编辑合并在了一个模型里, 最多能同时输入 16 张参考图.
更牛的是官方给的速度是不到 10 秒出一张 4K 图 (当然这个速度没写硬件, 但估计要H100以上了), 比主流方案最多快 5 倍!
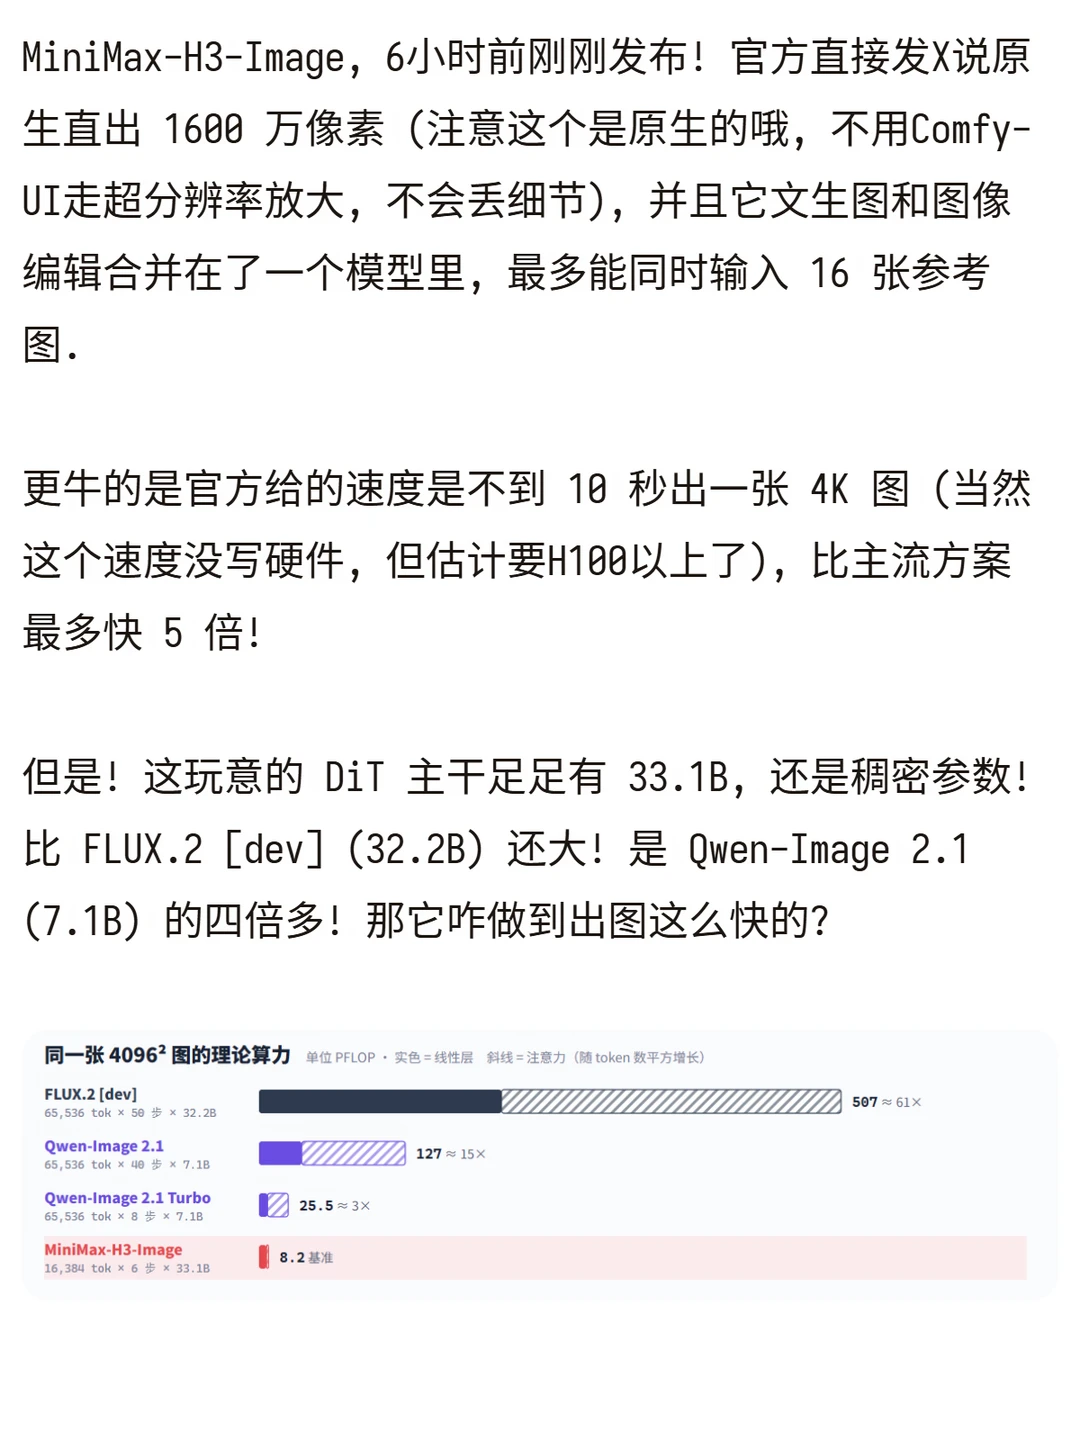
但是! 这玩意的 DiT 主干足足有 33.1B, 还是稠密参数! 比 FLUX.2 [dev] (32.2B) 还大! 那它咋做到出图这么快的?
来, 学习时间到了:
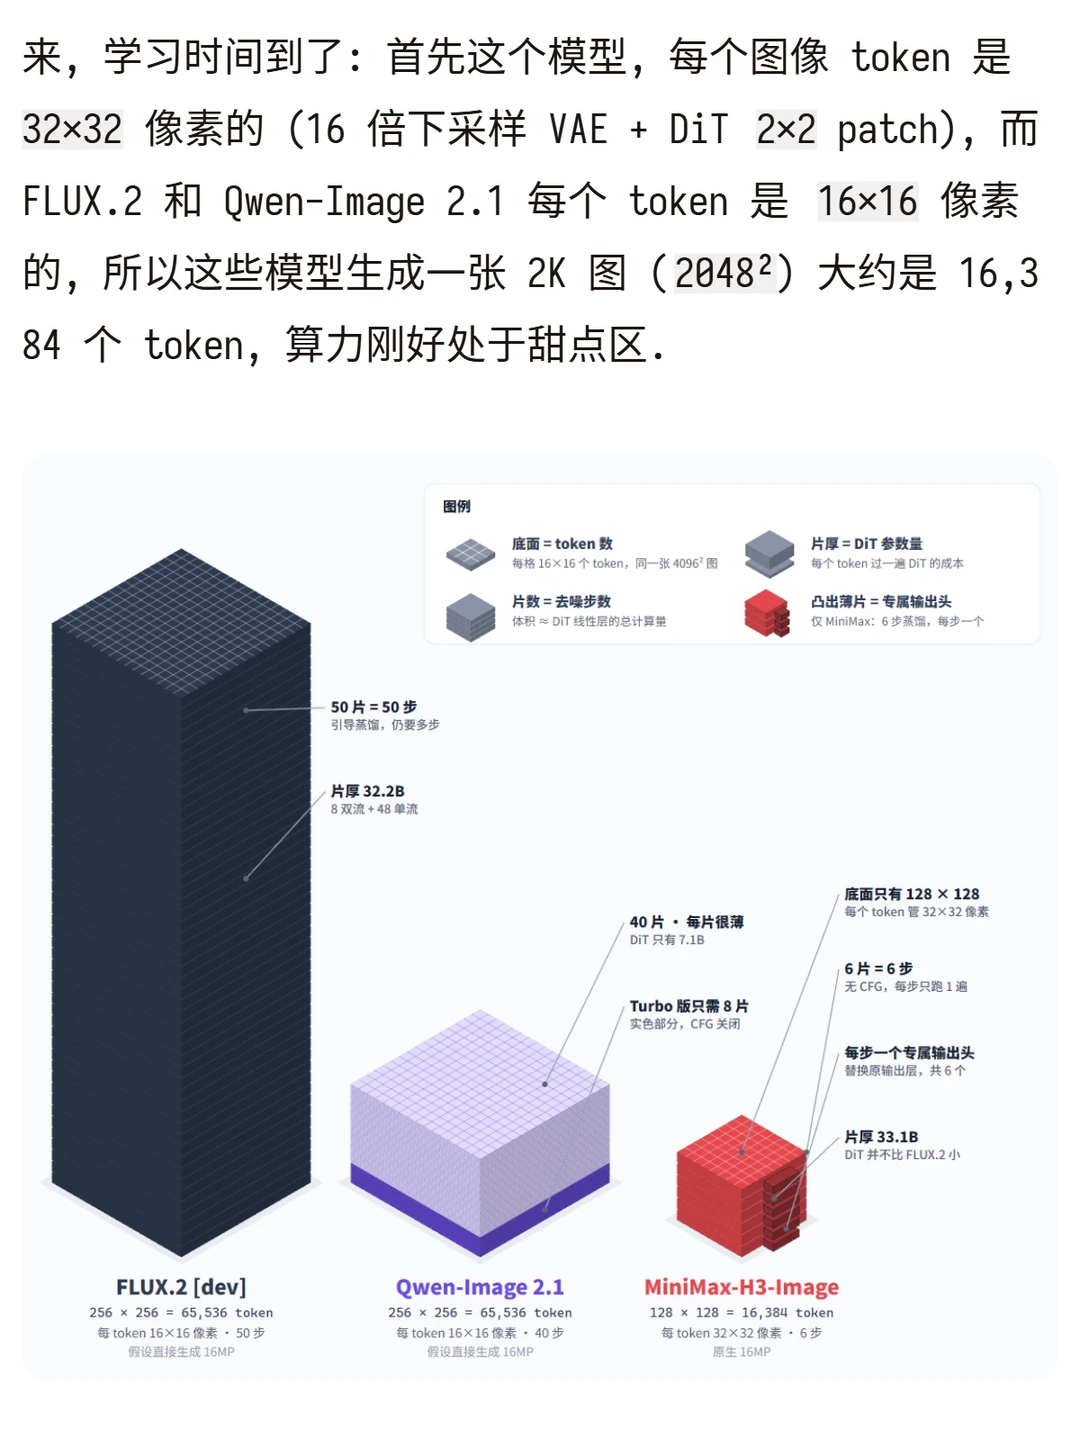
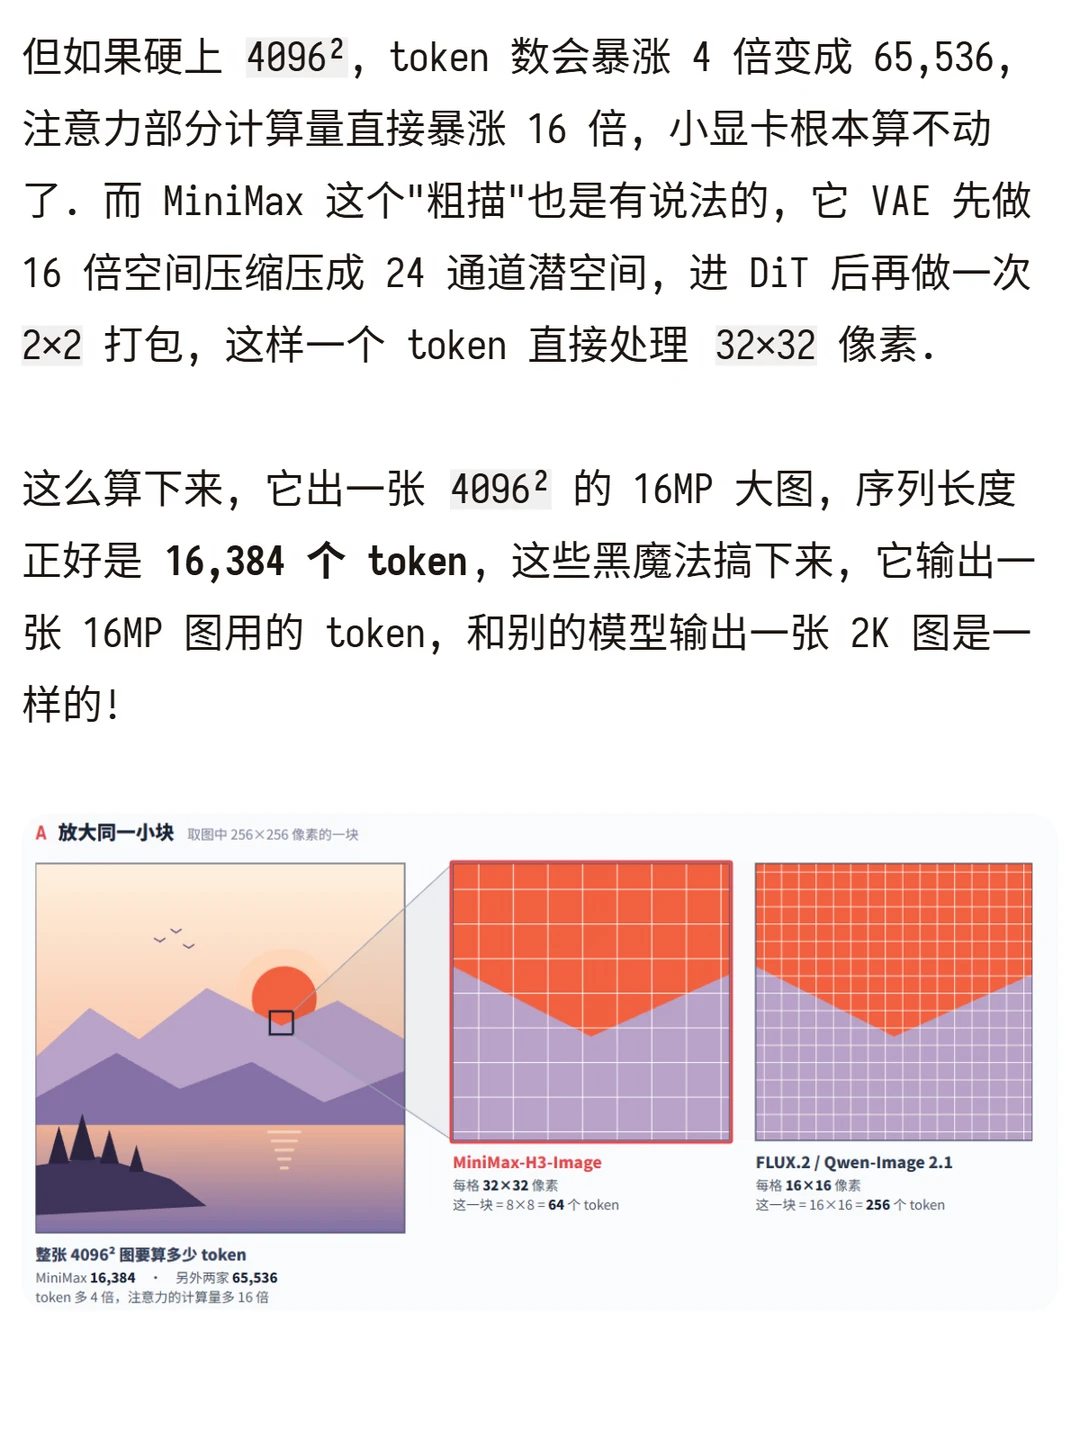
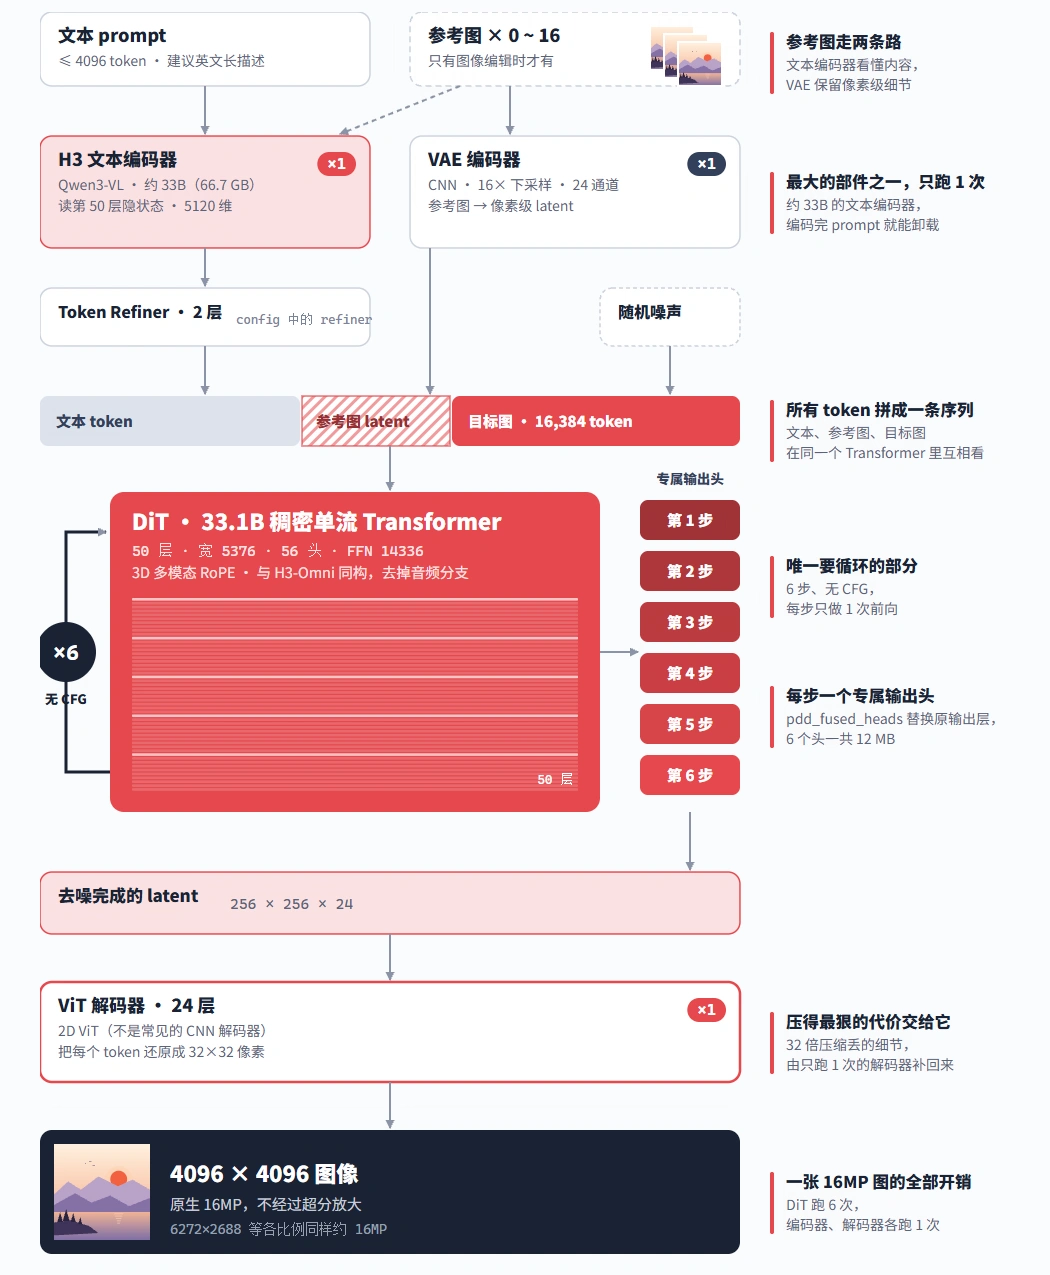
首先这个模型, 每个图像 token 是 `32×32` 像素的 (16 倍下采样 VAE + DiT `2×2` patch), 而 FLUX.2 和 Qwen-Image 2.1 每个 token 是 `16×16` 像素的, 所以这些模型生成一张 2K 图 (`2048²`) 大约是 16,384 个 token, 算力刚好处于甜点区. 但如果硬上 `4096²`, token 数会暴涨 4 倍变成 65,536, 注意力部分计算量直接暴涨 16 倍, 小显卡根本算不动了.
而 MiniMax 这个"粗描"也是有说法的, 它 VAE 先做 16 倍空间压缩压成 24 通道潜空间, 进 DiT 后再做一次 `2×2` 打包, 这样一个 token 直接处理 `32×32` 像素.
这么算下来, 它出一张 `4096²` 的 16MP 大图, 序列长度正好是 **16,384 个 token**, 这些黑魔法搞下来, 它输出一张 16MP 图用的 token, 和别的模型输出一张 2K 图是一样的!
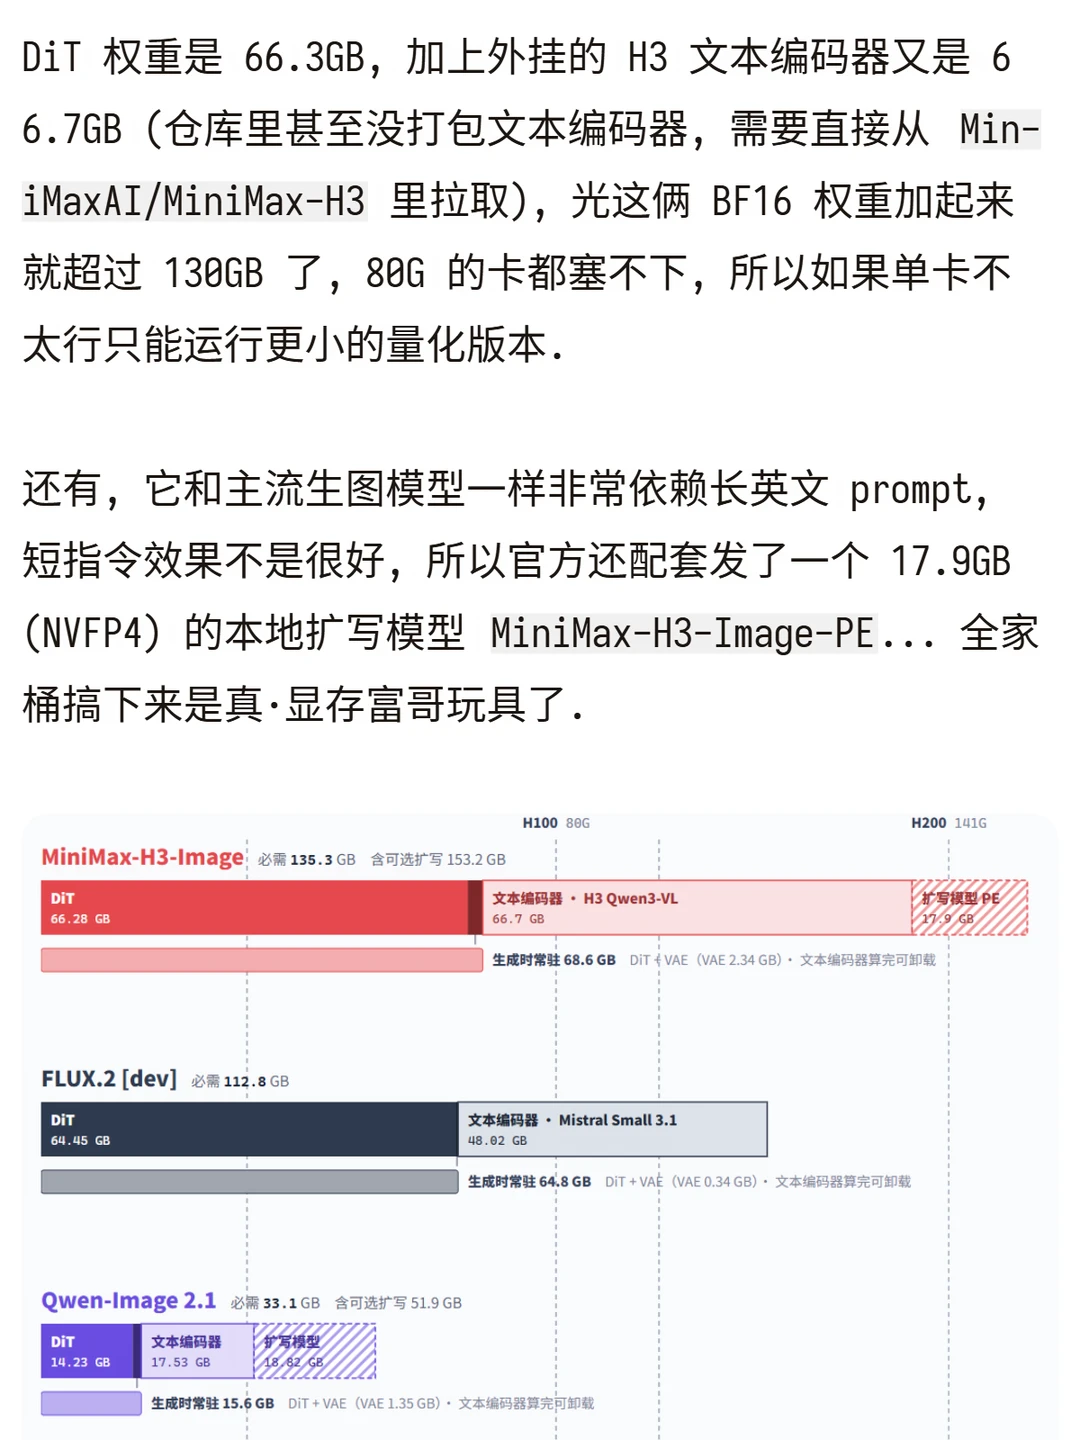
但是注意, 它虽然省算力, 但一点没省显存容量. 目前 DiT 权重是 66.3GB, 加上外挂的 H3 文本编码器又是 66.7GB (仓库里甚至没打包文本编码器, 需要直接从 `MiniMaxAI/MiniMax-H3` 里拉取), 光这俩 BF16 权重加起来就超过 130GB 了, 80G 的卡都塞不下, 所以如果单卡不太行只能运行更小的量化版本.
一会我给大家本地测一下量化版本效果怎么样, 敬请期待~
#MiniMax #MiniMaxH3Image #AI绘画 #生图模型