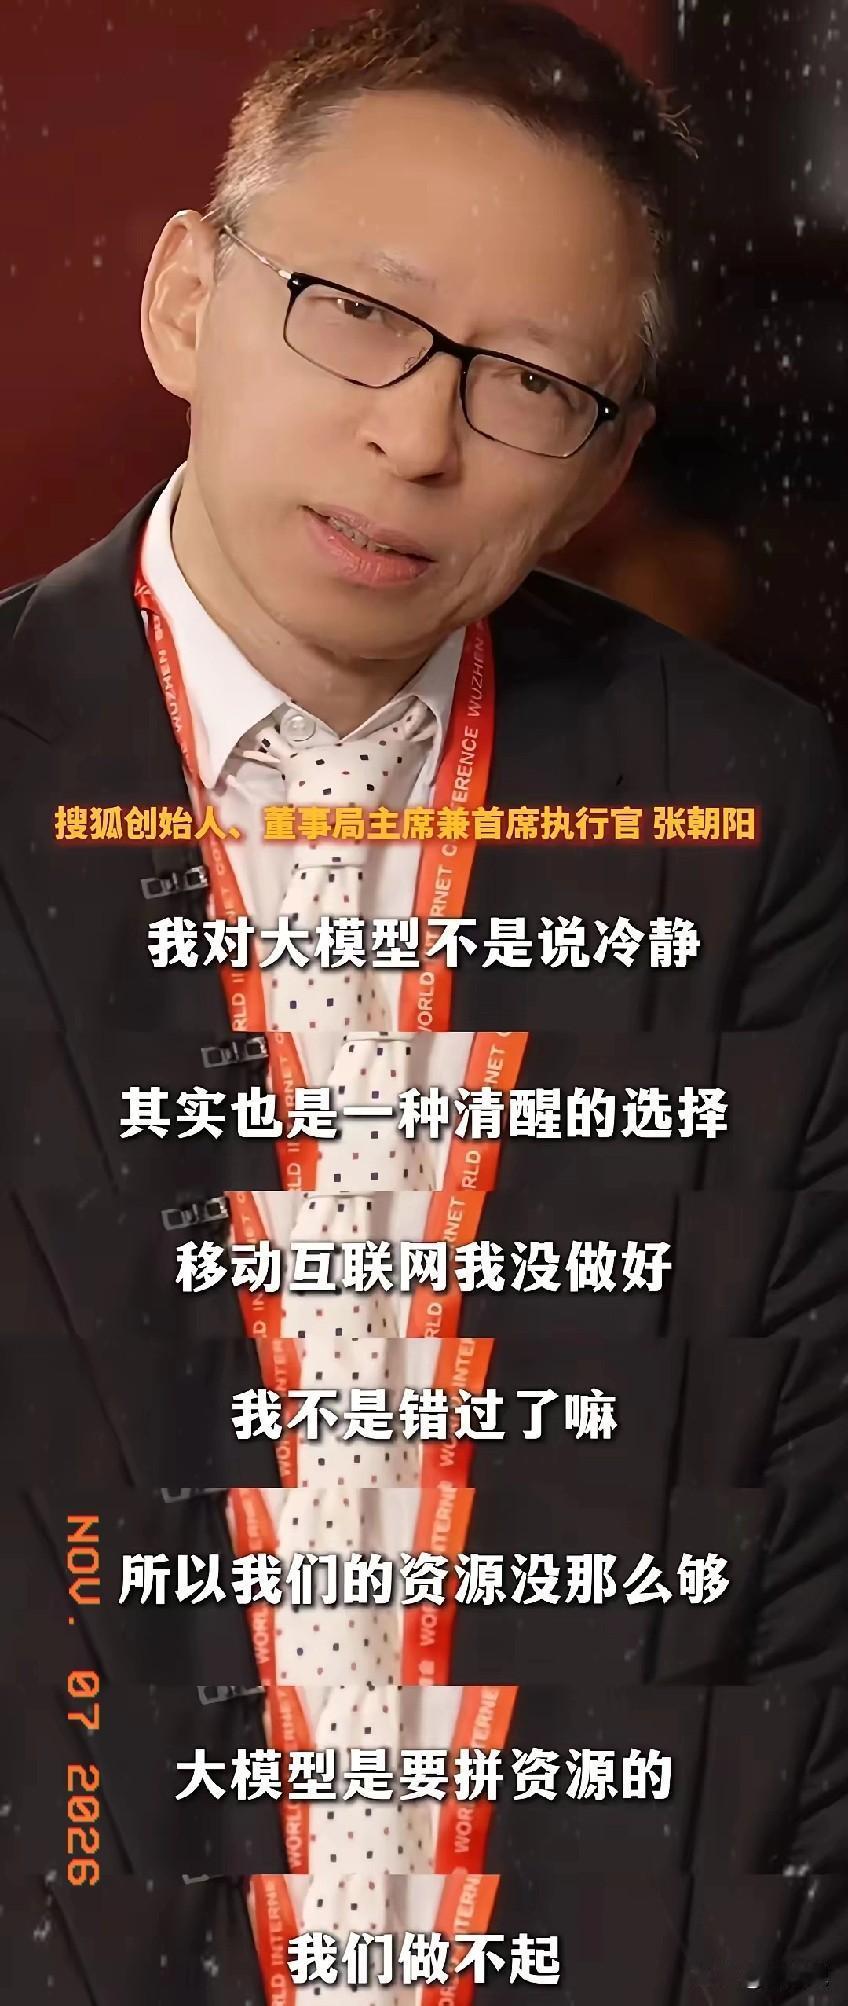
在2026年乌镇世界互联网大会的现场,搜狐创始人张朝阳说了一句久违的大实话:“我们做不起大模型。”
他坦言,因为自己当年错过了移动互联网,导致搜狐如今积累的资源有限。而大模型是一场极度依赖算力和资金的资源游戏,“我们资源没那么多,做不起。”
这句话从张朝阳嘴里说出来,台下反应不大。
他没说错,是说对了,还对得让人不舒服。过去三年,乌镇攒了无数场关于大模型的局,台上的人聊参数、聊AGI、聊“重做一遍所有产品”,很少有人把“钱从哪来”摆到台面上。张朝阳是第一个坐在那张椅子上、用聊天气的口吻说“我掏不起这个钱”的人。
虎嗅评论区有条留言,说“不要听loser的任何观点”。这话挺刻薄,但也把行业里一种拧巴心态露出来了:你可以做不起,但你不能说出来。说出来就是认输,认输就低人一等。
可张朝阳真的只是在认输吗?
搜狐2025年全年财报显示,总收入5.84亿美元,在线游戏收入5.06亿,营销服务收入6000万。到今天,搜狐本质上就是一家靠老游戏养着的公司。游戏还在赚钱,但游戏赚的钱要养整个盘子,要回购股票,要维持一家二十多年老互联网公司的体面。
2026年一场前沿大模型的单次训练成本,按Zenodo上2026年3月发表的一份AI经济学论文给出的口径,已经越过1亿美元,下一代系统奔着10亿美元去。
这两个数字摆在一块儿,张朝阳那句“做不起”就不用再加什么修饰了。他一年全部进账,不够烧一次前沿训练。烧完了还不保证训得出来。训出来了还不保证有人用。
这跟战略选择关系不大,就是算术。
那些在2023年喊过“All in大模型”的中型公司,后来怎么样了?腾讯云社区有篇复盘写得很老实:大多数项目“悄无声息地停掉了,或者缩减成了一个小规模的微调实验小组”。立项的时候PPT上写着数据自主、能力定制,两年后连周报都不好意思提。算力买回来训练完就吃灰,推理用不满,卖又卖不掉,养着是固定成本。算法工程师招来了留不住,走的时候代码注释都没写全。
零一万物在2025年3月宣布不再训练万亿参数规模的超大基模,转向轻量化模型和企业应用。李开复当时对第一财经说,调整后的公司“不再训练万亿参数规模的超大基模”。那家公司背后站着李开复,也拿过融资,技术班底不算弱。连它都往后退了一步。
张朝阳不过是把这场退潮里绝大多数人不敢开口的那句话说出来了。
他说“不是冷静,是一种清醒的选择”。清醒在哪儿?就在他清楚自己手里那点筹码该押哪张桌。搜狐宣布后续侧重AI工具应用落地,不碰基础大模型的自研。直白点讲,别人去淘金,他卖铲子;别人修高速公路,他在路边支个摊。
这条路能不能走通,另说。但至少他没有拿股东的钱去填一个自己算过账、知道填不满的坑。
行业对“做不起”这三个字的反应,有点过敏。张朝阳说自己做不起,评论区就冒出一堆“loser”的嘲讽。可那些嘲讽他的人里,有多少正在烧着根本收不回来的钱,开着根本没人用的模型发布会,写着根本经不起尽调的BP?
大模型走到2026年,前排牌桌上坐着的,要么是利润厚到可以拿几十亿美元试错的平台公司,要么是背后有国家级资金支撑的团队。全球真正在跑前沿训练的实验室,一只手数得过来。这不叫悲观,眼前就是这个样子。
张朝阳的“做不起”刺耳,是因为它戳破了一层窗户纸:这行里做不起的人远比做得起的人多,敢承认的,一只手也数得过来。
当年错过移动互联网,搜狐从一线掉到二线,从二线掉到“还在”。这个代价他认了,认得很干脆。如今他不想再为一个自己掏不起的局,把剩下的筹码也推出去。
你可以说他保守,说他没野心,说他早就不是那个在天安门前滑滑板的张朝阳了。
但你不能说他算错了账。
各位读者你们怎么看?评论区讨论