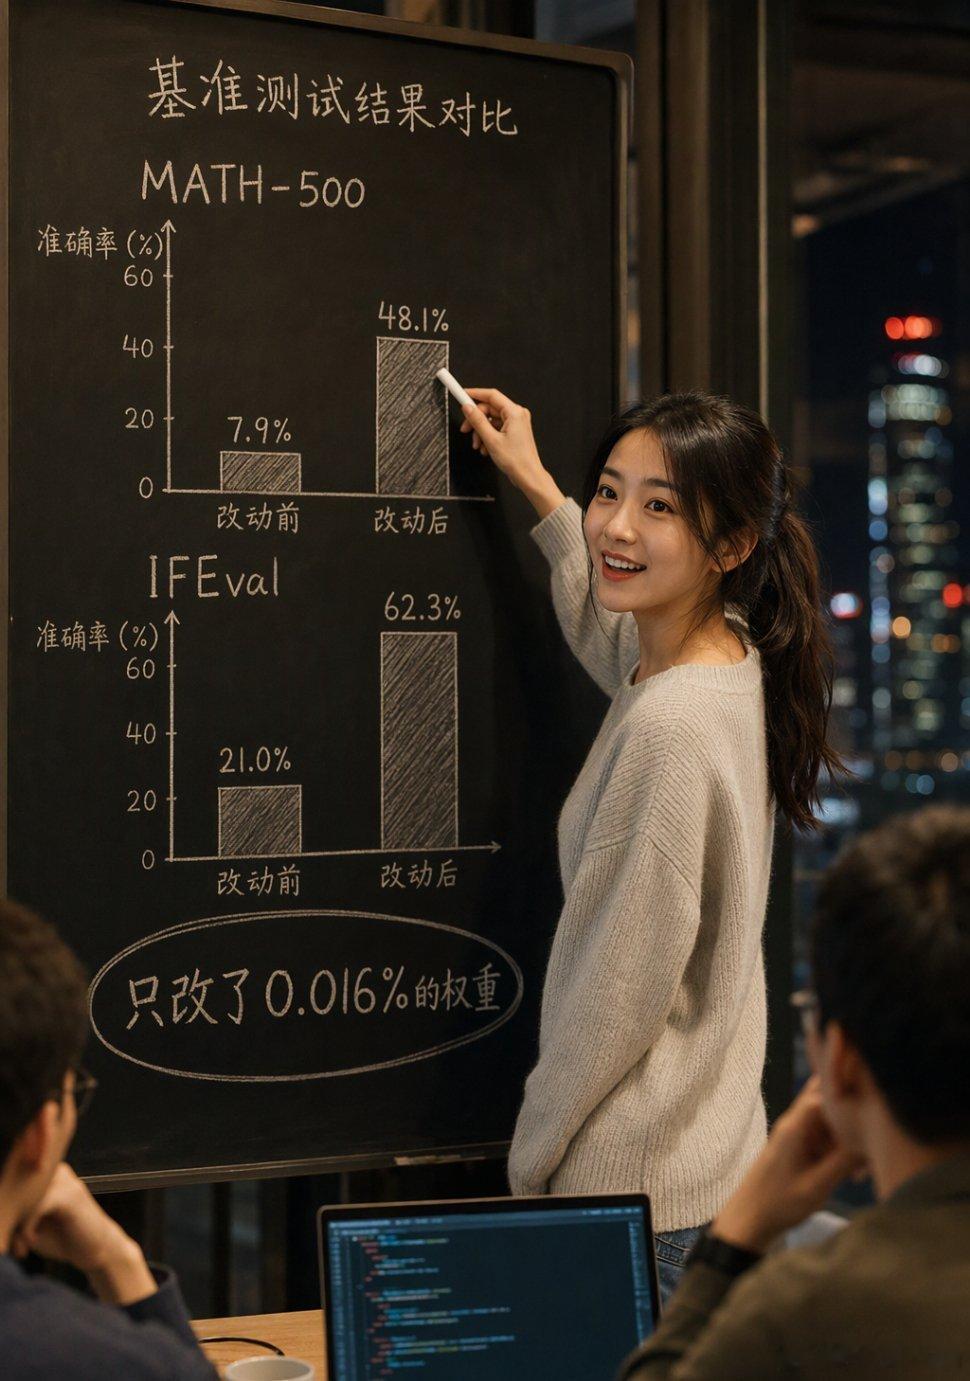
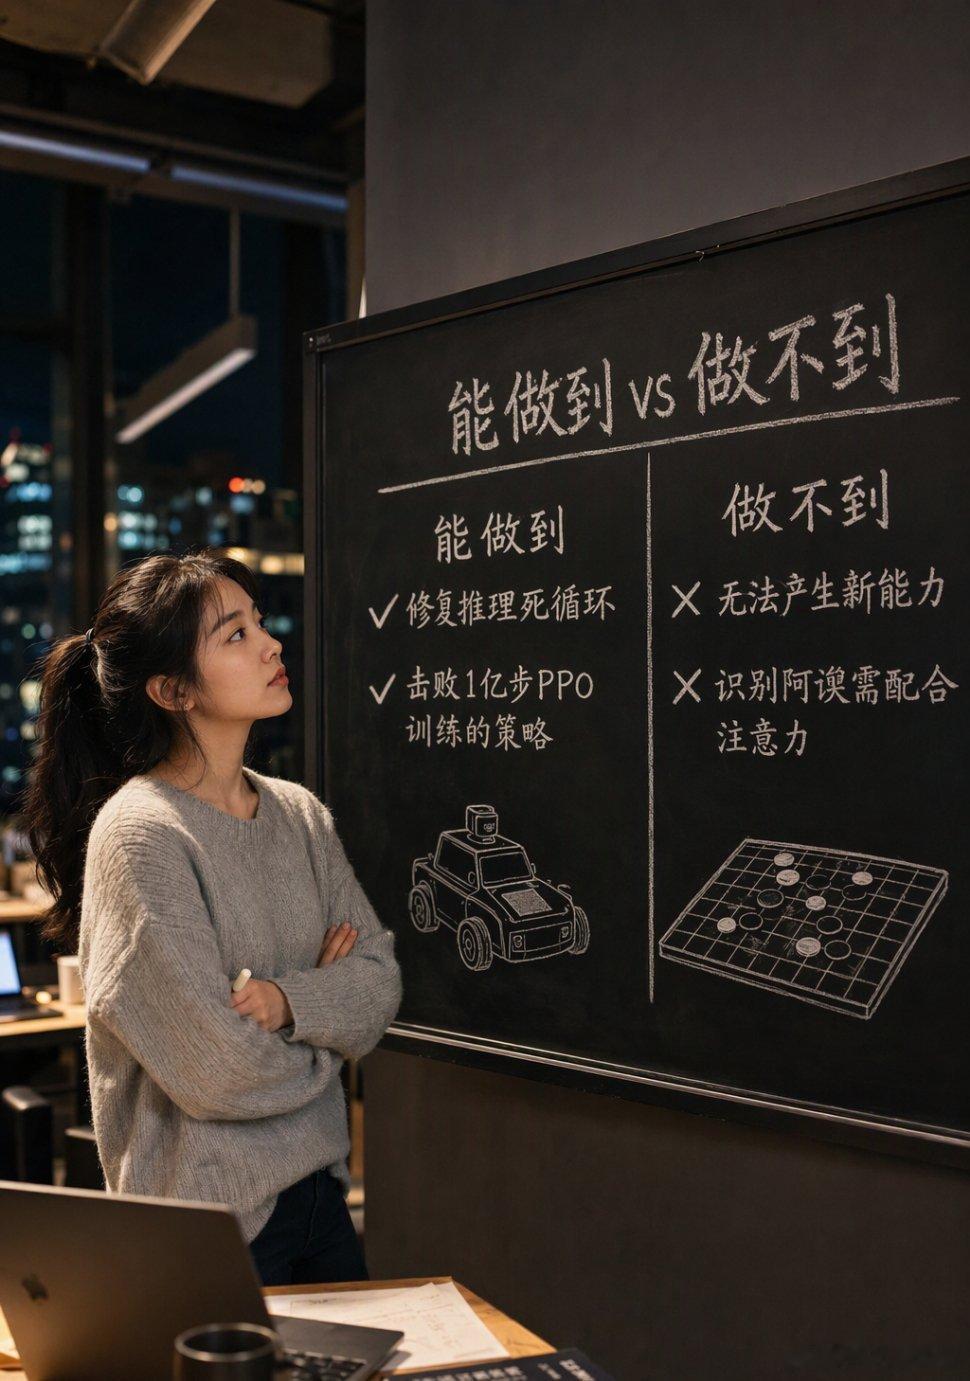
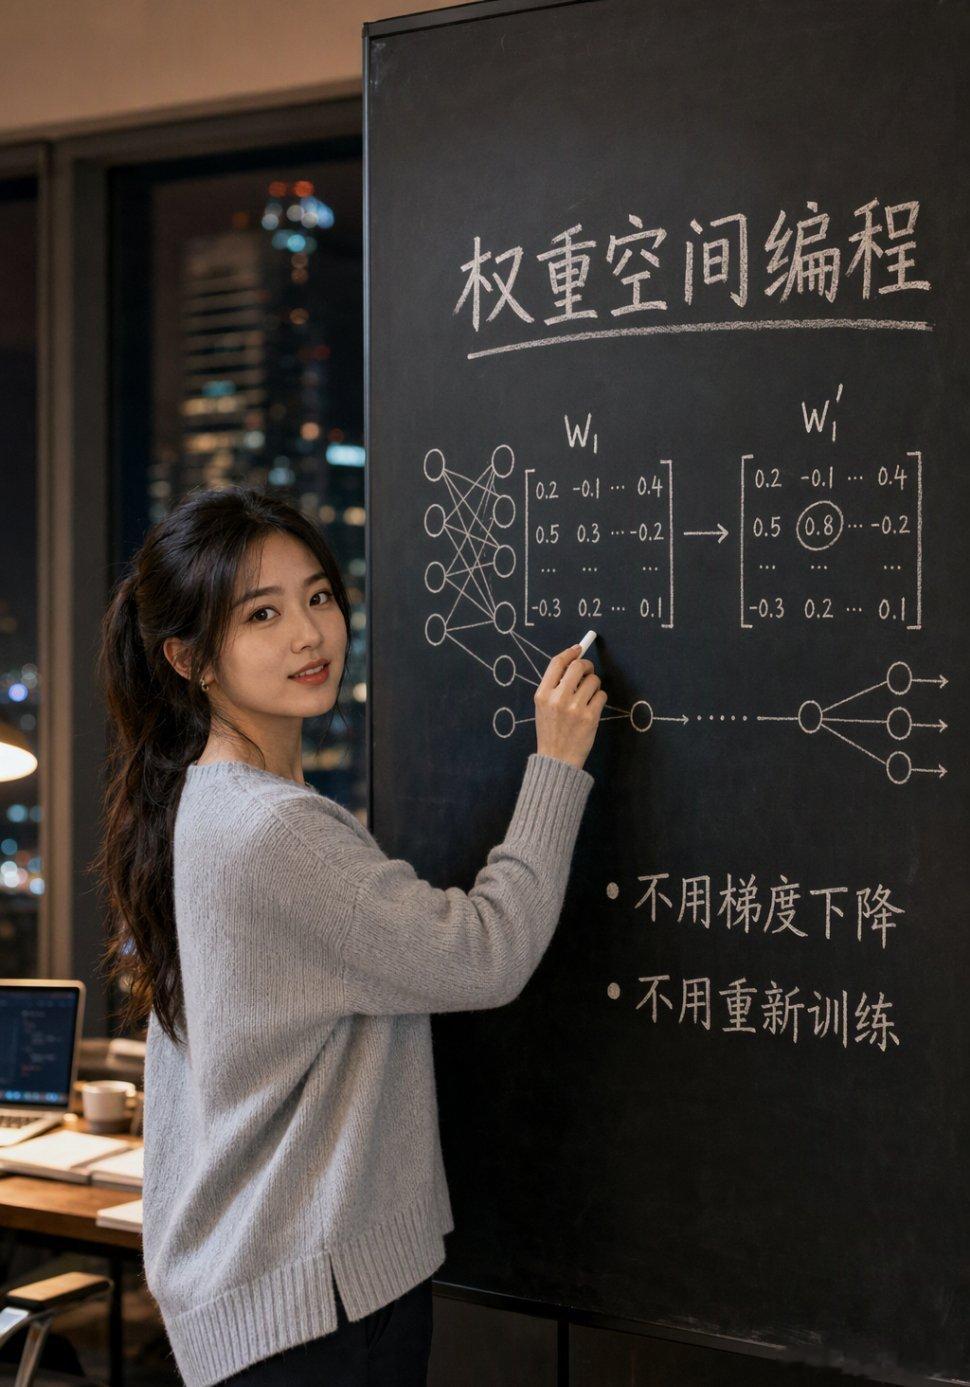
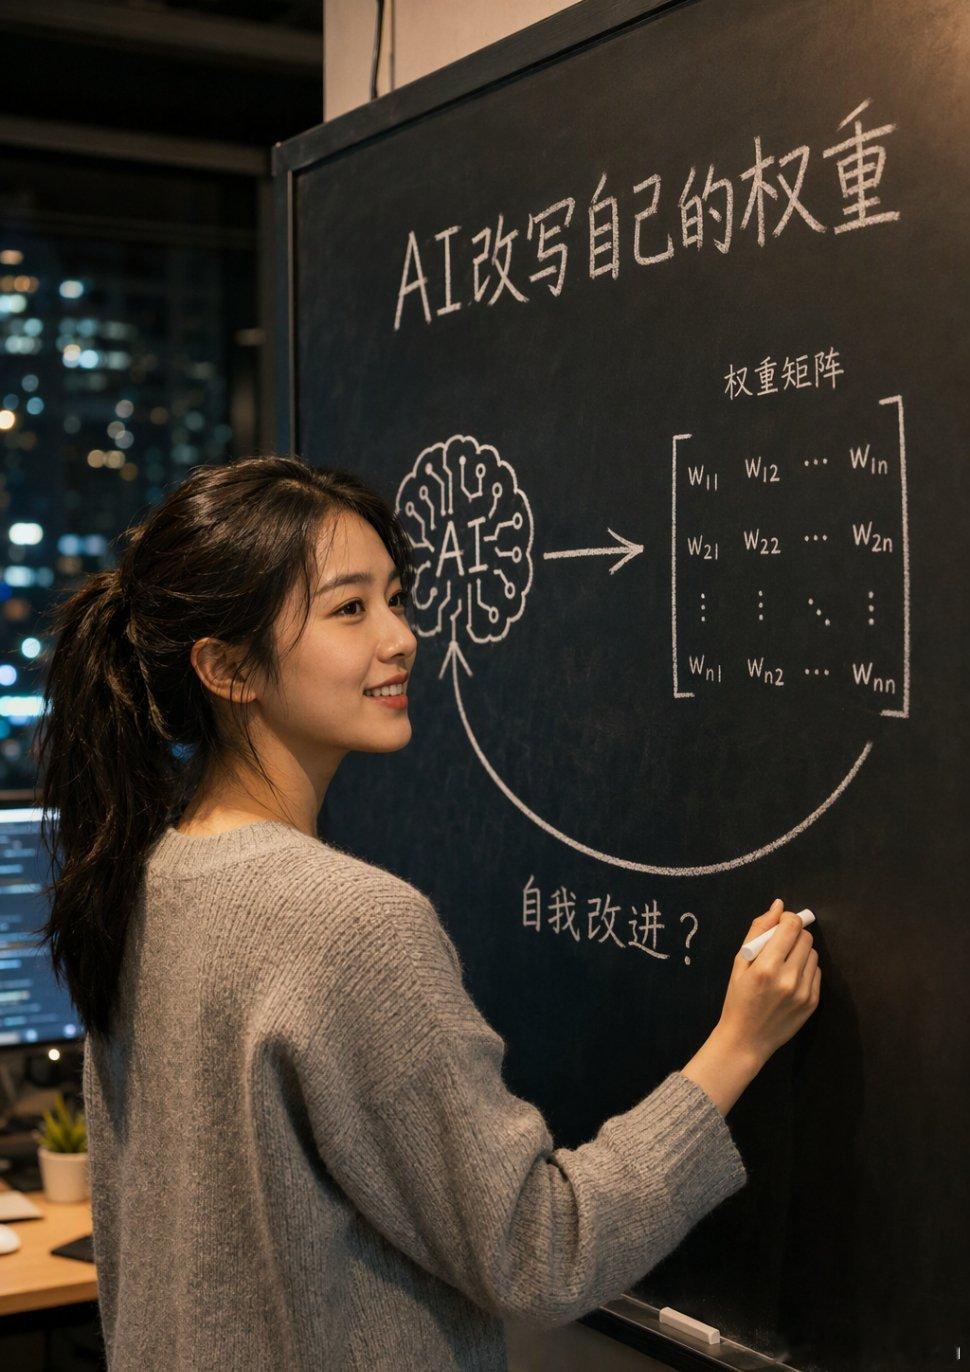
当模型开始直接改写自己的权重【MIT CSAIL 演示「权重空间编程」:当模型开始直接改写自己的权重】▍它是什么MIT CSAIL 团队(Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab)发布博客《Sparks of Weight-Space Programming》,展示 GPT-6 Astra 仅凭权重文本就能读取、修复、从零编写神经网络权重——全程不使用梯度下降、不重新训练,作者称之为「权重空间编程」(Weight-Space Programming)。换句话说,以前要改模型行为得靠微调或 RL,现在改成用自然语言告诉模型「哪里不对」,它直接去改权重。▍最硬的一组证据在 Qwen3.5-0.8B 上,Astra 定位并修复了导致「推理死循环」的权重问题,只编辑了 0.016% 的参数(约 13 万个权重、158 轮对话、17 步编辑),MATH-500 就从 7.9% 提升到 48.1%,IFEval 从 21.0% 升到 62.3%(50 forward passes 口径)。这不是靠更多数据喂出来的,是改了权重本身。▍还能做到什么仅凭 17,253 个权重的文本,Astra 以 99% 的置信度认出了策略网络训练的是什么游戏;一次编辑把 1,024 次全败的小车控制策略修复到 100% 成功;从零写出的 MinAtar 与围棋策略网络,击败了用 1 亿步 PPO 训练出来的网络。▍它做不到什么作者也写明了局限:这个方法目前只能解锁模型既有能力,变不出新能力(在 Gemma 3 270M 上直接失效);仅凭权重识别不了阿谀倾向,需要配合观察注意力分布。而且 8 组实验共 1,125 轮对话日志已开源(逐轮审计无工具调用),修复后的权重也上传了 Hugging Face——但结果仍是研究团队自述,尚待独立复现。▍为什么这件事不一样要指出的是:过去我们说「改模型」几乎等于「收集数据 + 重训」,而这里把这一步压缩成了对 13 万权重的一次编辑。如果后续被独立复现证实,模型能力修复可以绕开数据收集与重训,也为「AI 检查并修改自身或下一代模型权重」的递归自我改进路线,提供了最早的实证线索。需要说明的是,它离真正可控、可信的自我改写还远,但其意义在于把「改权重」从工程黑箱变成了可被语言和日志审计的操作。人工智能 科技 人工智能