权重装得下为什么还爆显存?KV缓存全算清
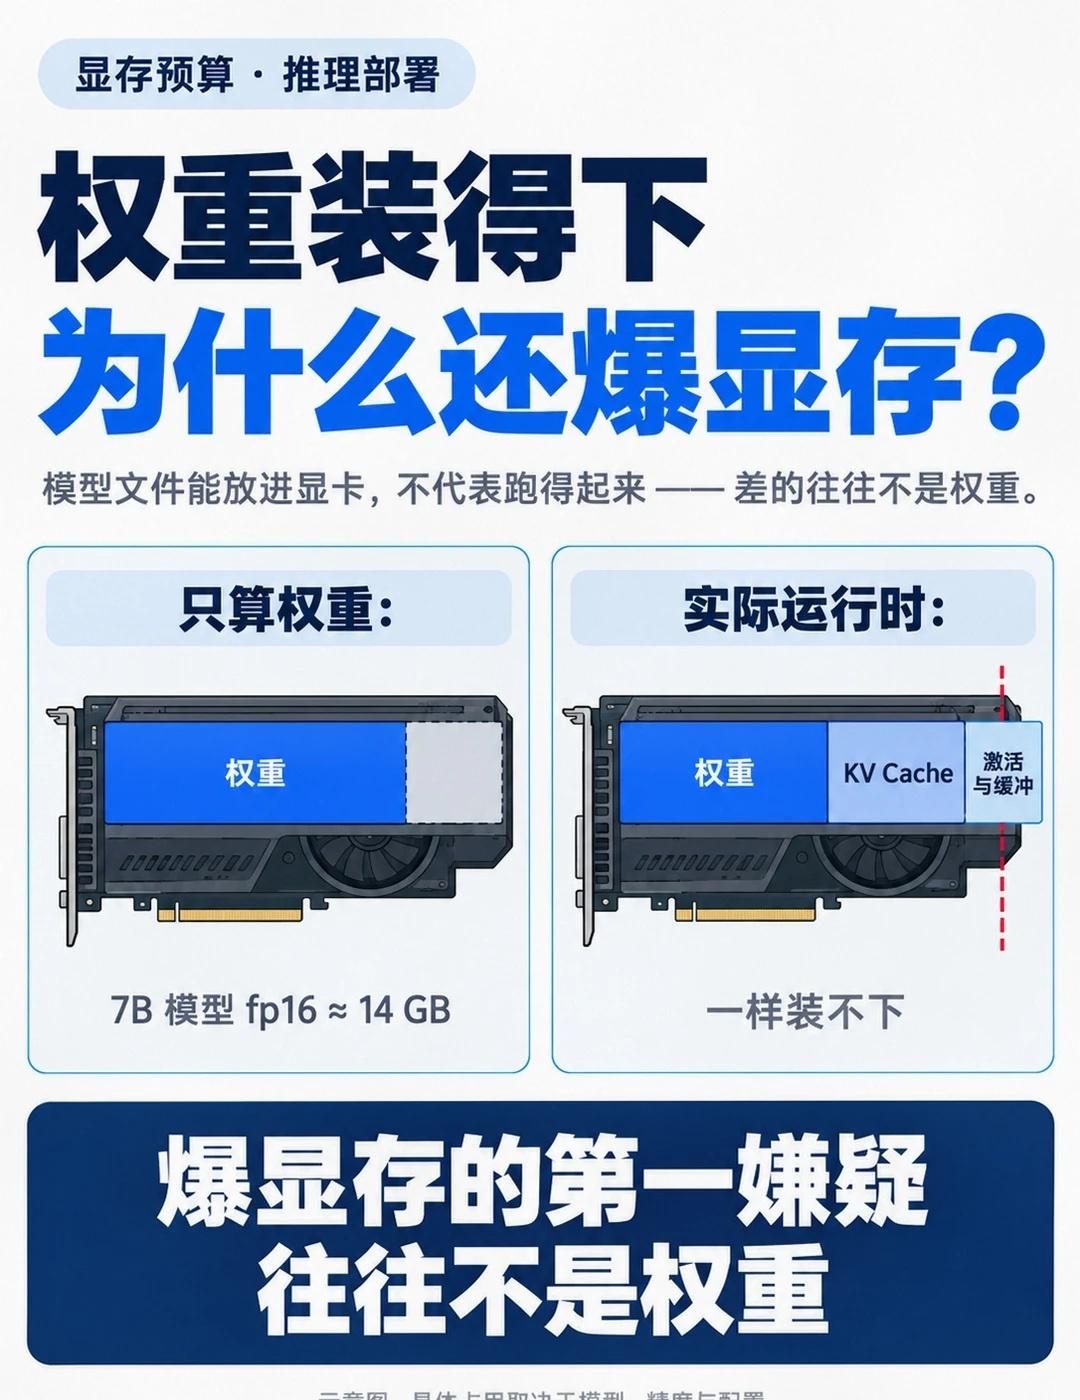
很多人算显存只算权重:7B 模型 fp16 不到 15 GB,一张 24 GB 的卡明明放得下。
上线的第一周就 OOM 了。
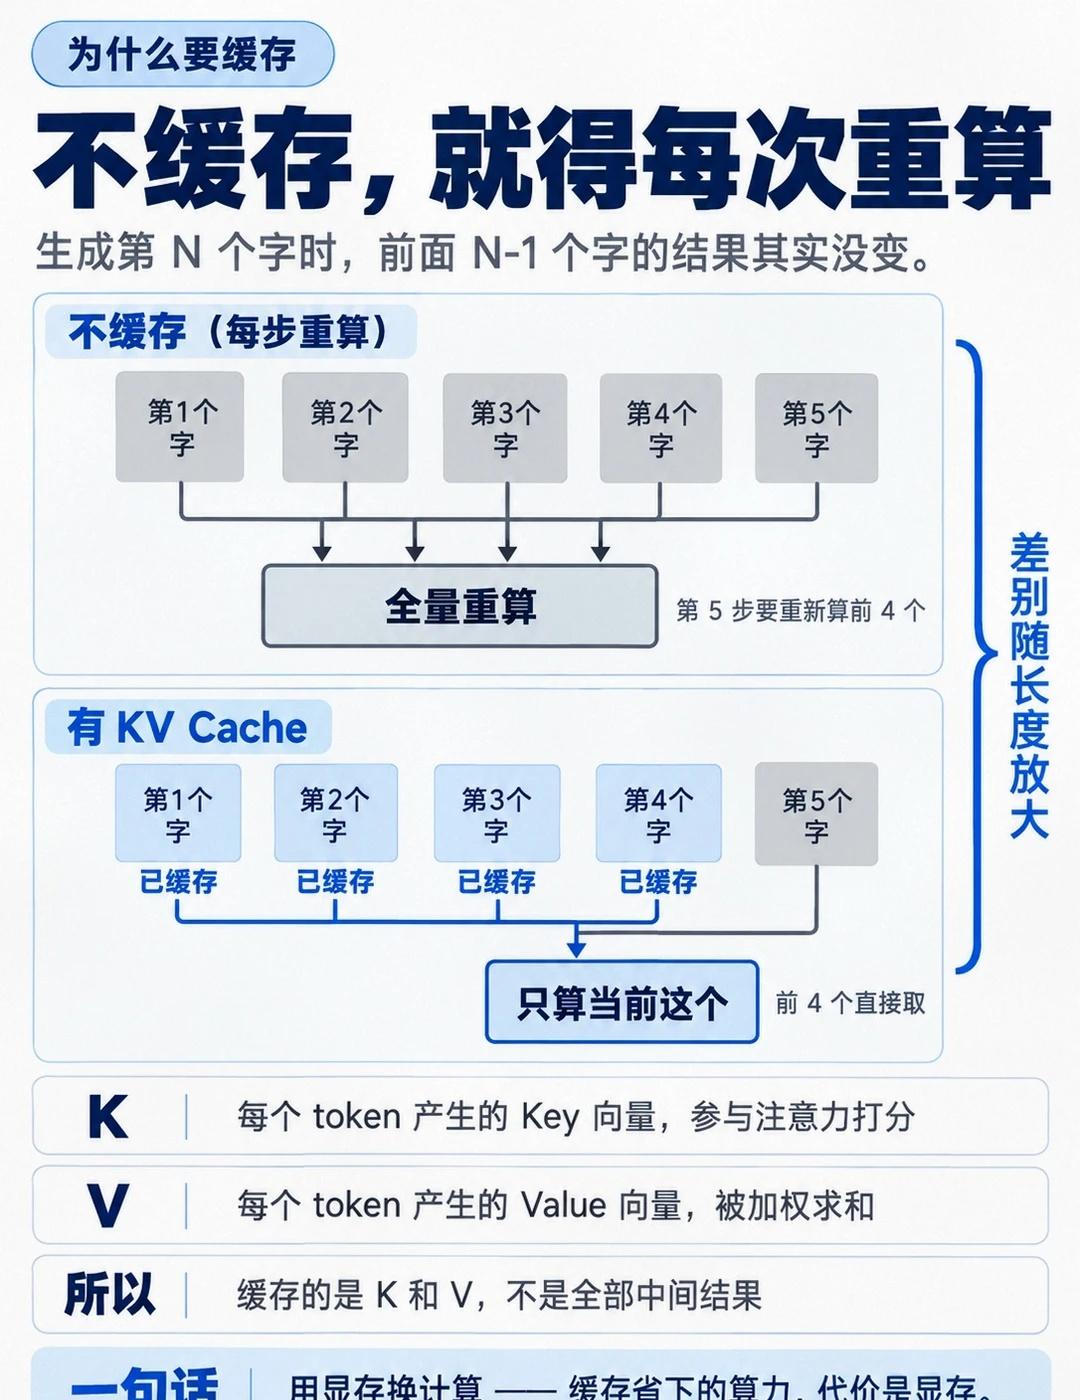
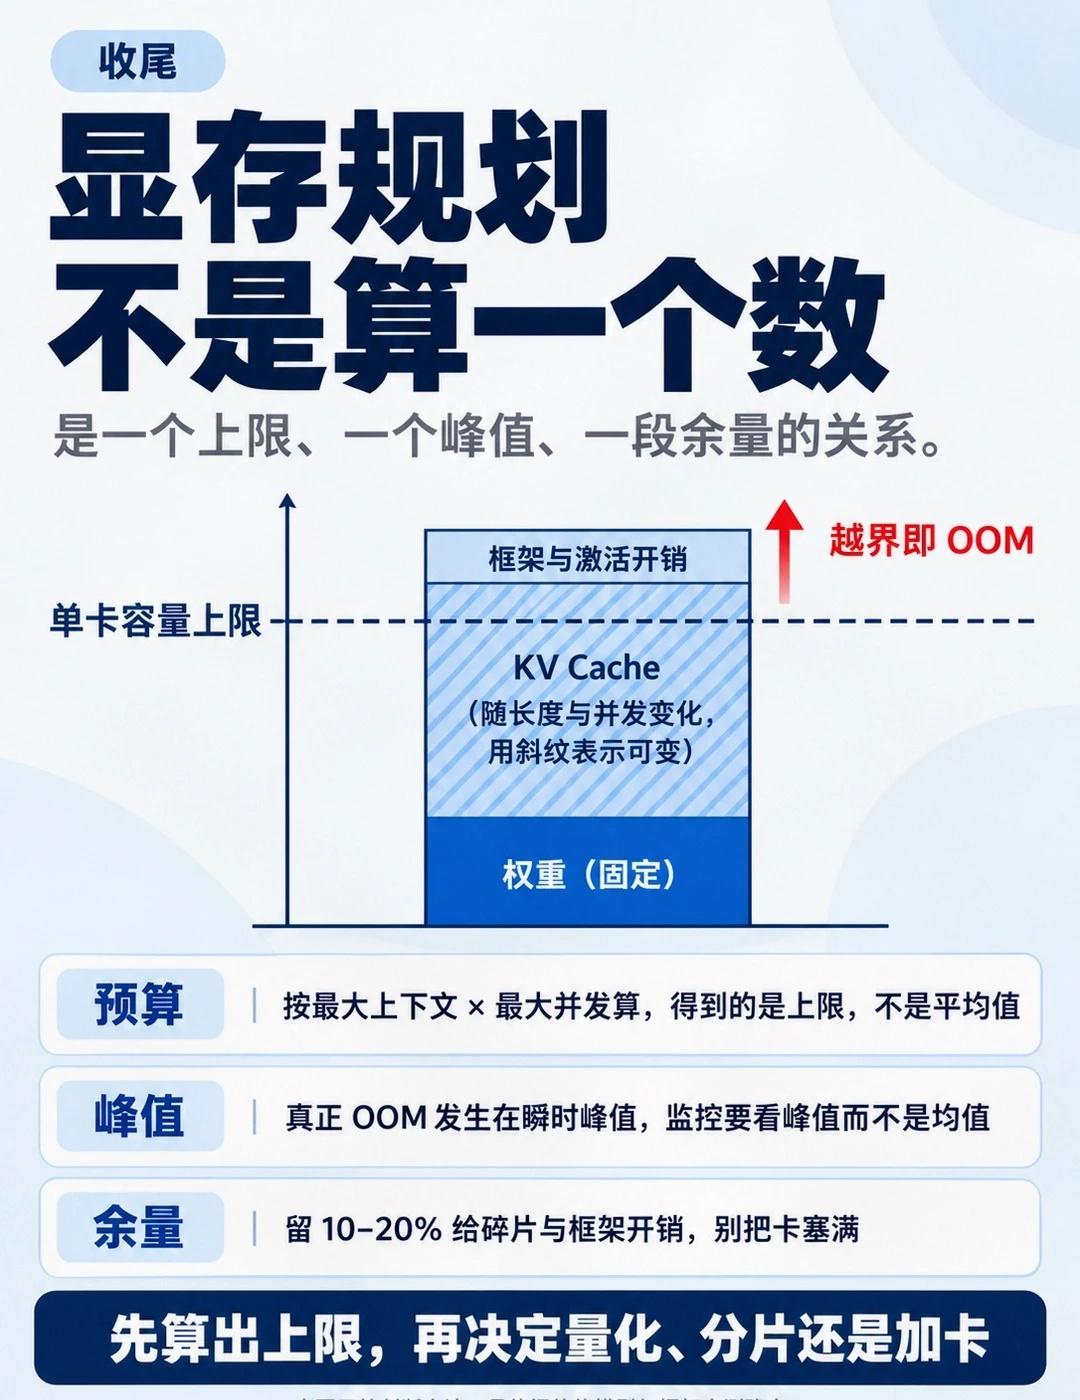
差额在 KV Cache 上——它不是"额外开销",是每生成一个 token 都要多占一份的东西。而且它跟两个变量同时成正比:上下文长度、并发数。
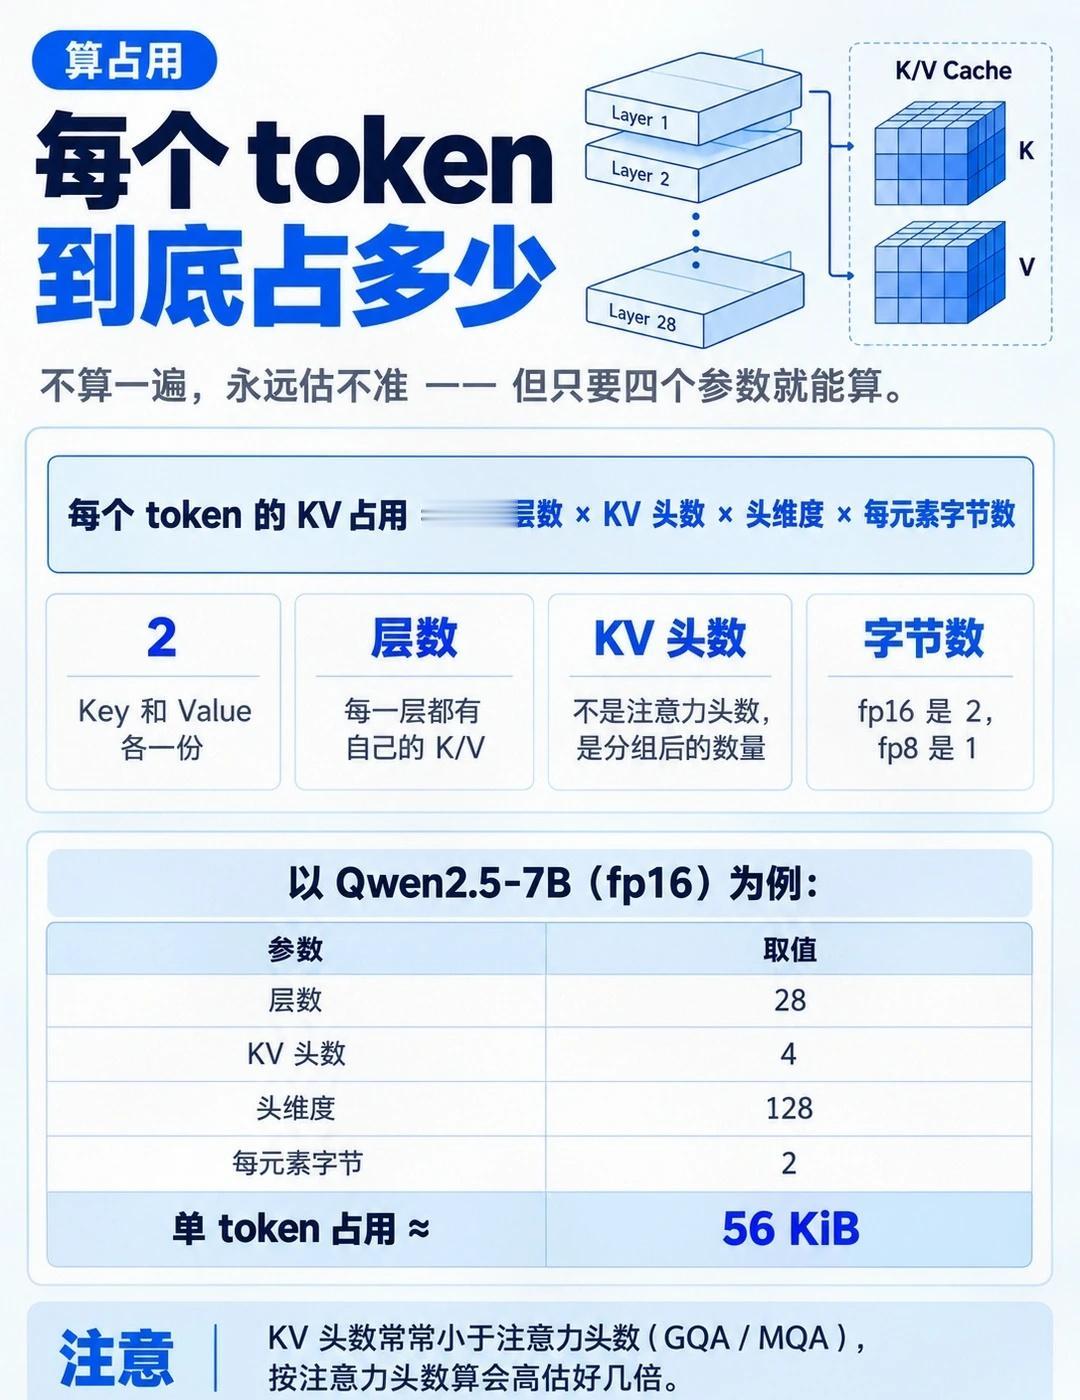
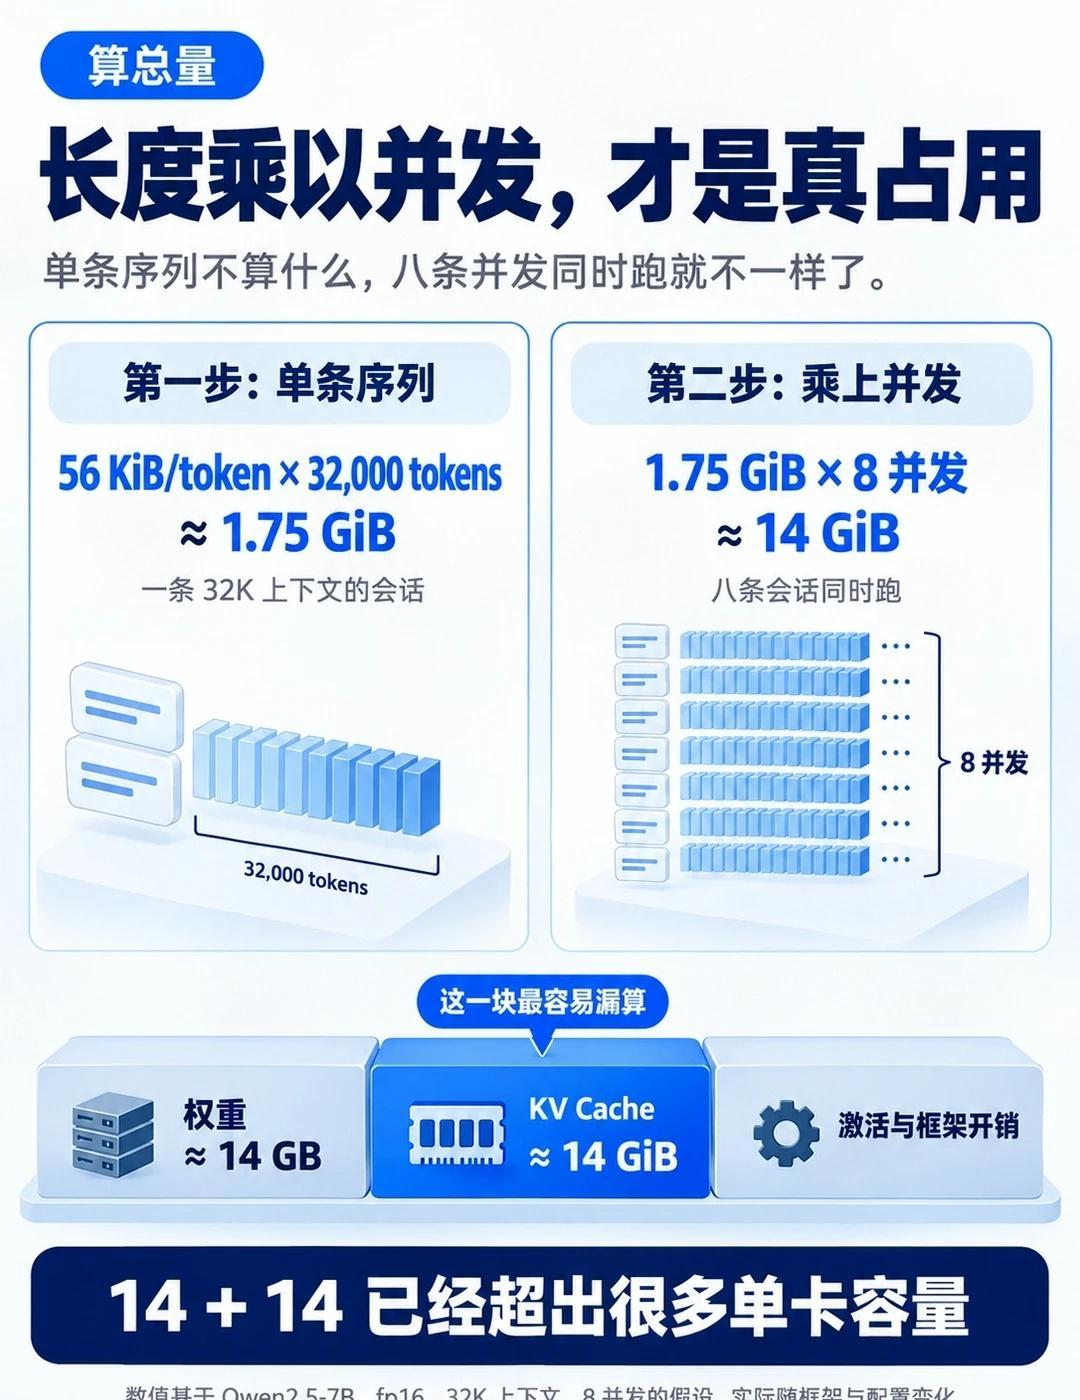
以 Qwen2.5-7B 算,fp16 下单 token 的 KV 占用约 56 KiB。一条 32K 的会话就是 1.75 GiB;开八条并发,14 GiB。加上权重,14 + 14,已经超出很多单卡容量。
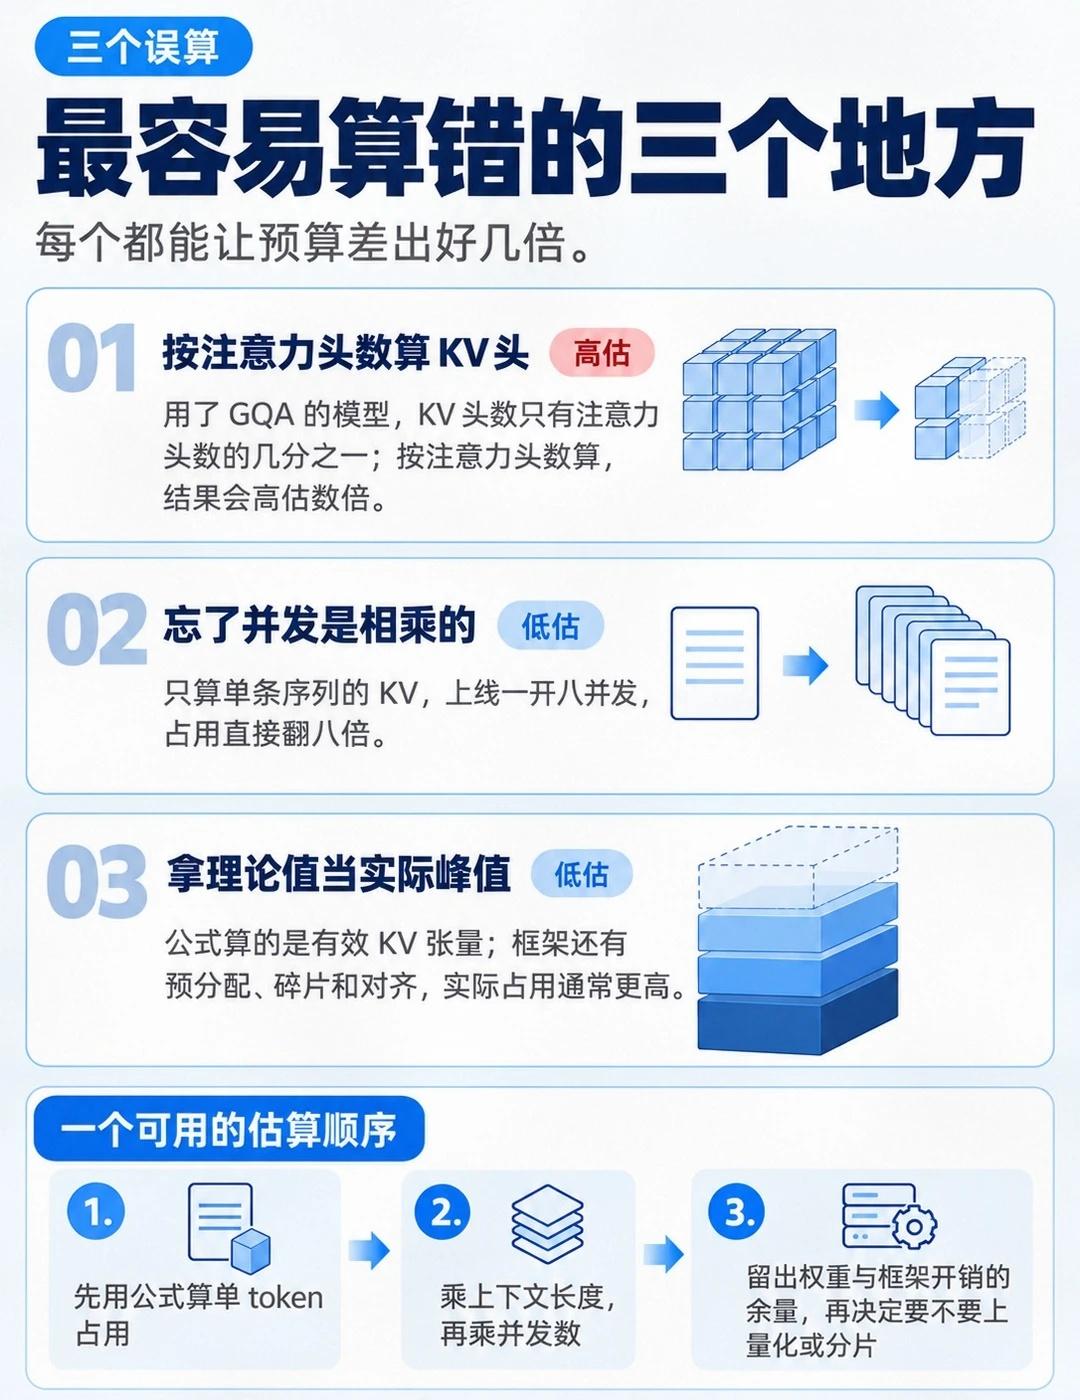
**三个最容易算错的地方:**
· 按注意力头数算 KV 头数 —— 用了 GQA 的模型,KV 头只有几分之一,你会高估好几倍
· 忘了并发是相乘的 —— 只算单条序列,上线直接翻八倍
· 拿公式值当实际峰值 —— 框架还有预分配、碎片和对齐
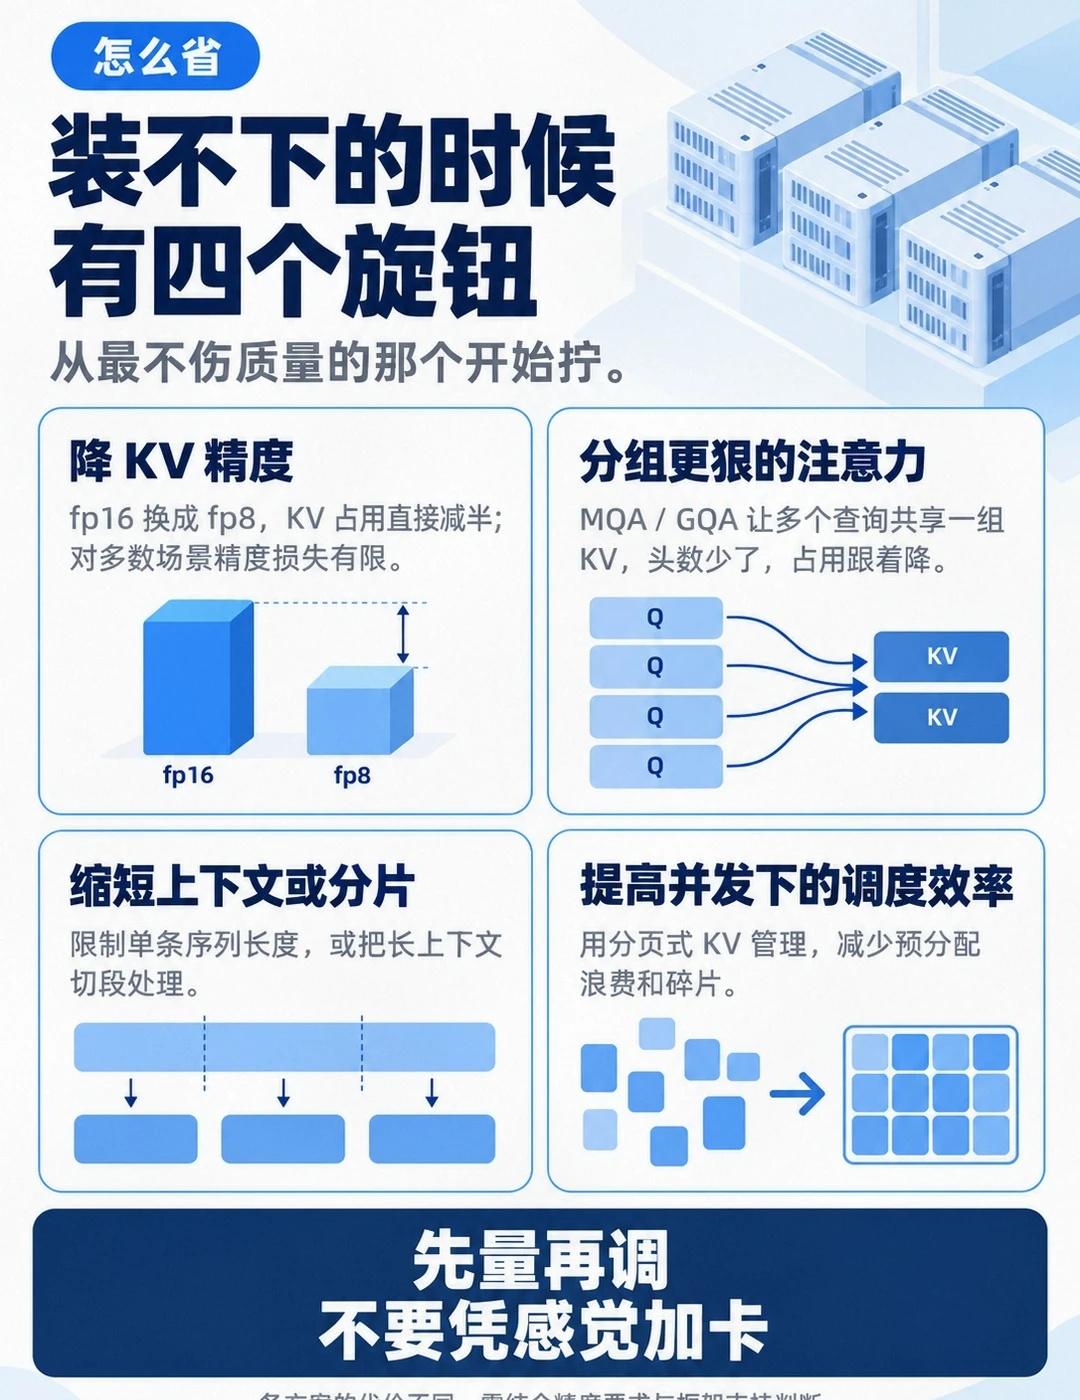
装不下的时候有四个旋钮:降 KV 精度、用分组更狠的注意力、缩短上下文或分片、提高调度效率。**从最不伤质量的那个开始拧。**
一句能记住的:用显存换计算。缓存省下的算力,代价是显存。
大模型部署 KV 显存优化 推理服务 GPU AI 算力 vLLM 模型部署