50美元造出媲美OpenAI O1的推理模型,中国开源模型成全球AI“水电煤”
砸7840万美元才能训出的顶级AI模型,现在有人花不到50美元就做出来了,竞赛数学成绩还比OpenAI的旗舰款高27%!
这事最近直接炸了整个AI圈,业内人看完全愣了。
斯坦福和华盛顿大学的研究团队,在AI领域泰斗李飞飞教授的带领下,就用16块普通显卡,总花费连50美元都不到,硬生生训出了个名叫S1的强悍推理模型。
你猜这模型性能有多猛?
数学运算、代码编写的能力直接追平OpenAI O1、Deepseek R1这些当下最顶尖的旗舰推理模型,就连难度拉满的竞赛数学题,表现都比O1 Pro预览版高出27%。
搁以前,想训出个同等级别的模型,光训练成本就得7840万美元,现在直接干到50美元,连人家零头的万分之一都不到。
为啥能把成本压到这么离谱的地步?
说穿了就俩核心原因。
第一是选的基座模型底子够硬,研究人员直接用了阿里云开源的千问2.5 32B,本身就已经在海量公开数据集上完成了预训练,特征表现能力拉满。
第二是人家根本不搞蛮力堆算力那套,就精心打磨了一个只有1000道题的精选数据集做定向微调,全靠巧劲出效果。
这哪是普通的技术突破啊,这是直接把“AI必须烧钱才能玩”的固有认知,按在地上降维打击。
以前AI研发是什么?是妥妥的豪门专属游戏,算力、资源、话语权全攥在少数几个科技巨头手里,普通小团队、个人开发者连入场的门都摸不到。
现在呢?高不可攀的门槛直接被踩得稀碎。
更值得咱们中国人骄傲的是,这次震惊全球的S1,根儿上依托的就是咱们中国的开源模型。
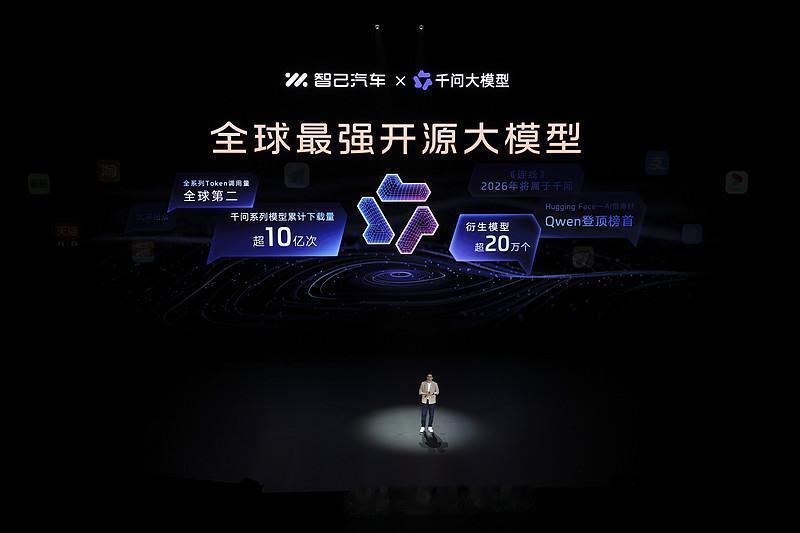
去看全球最大的AI开源社区Hugging Face的最新榜单,现在全球开源大模型前十,清一色全是阿里通义千问的衍生款。
等于咱们中国的开源模型,现在已经成了全球AI圈的“水电煤”,不管你是哪个国家的开发者,想搞AI创新,站在咱们的成熟基座上就能往上搭应用、训新模型,根本不用从零开始烧钱。
以前大家总觉得AI技术迭代得靠巨头砸几百亿烧出来,现在才发现,当技术不再是少数人的专属,50美元就能入场的时候,那些散在全球各个角落的普通开发者,才是真正能把AI玩出无限可能的人。
你说以后AI的发展话语权,还能一直攥在那几家靠烧钱堆出壁垒的巨头手里吗?