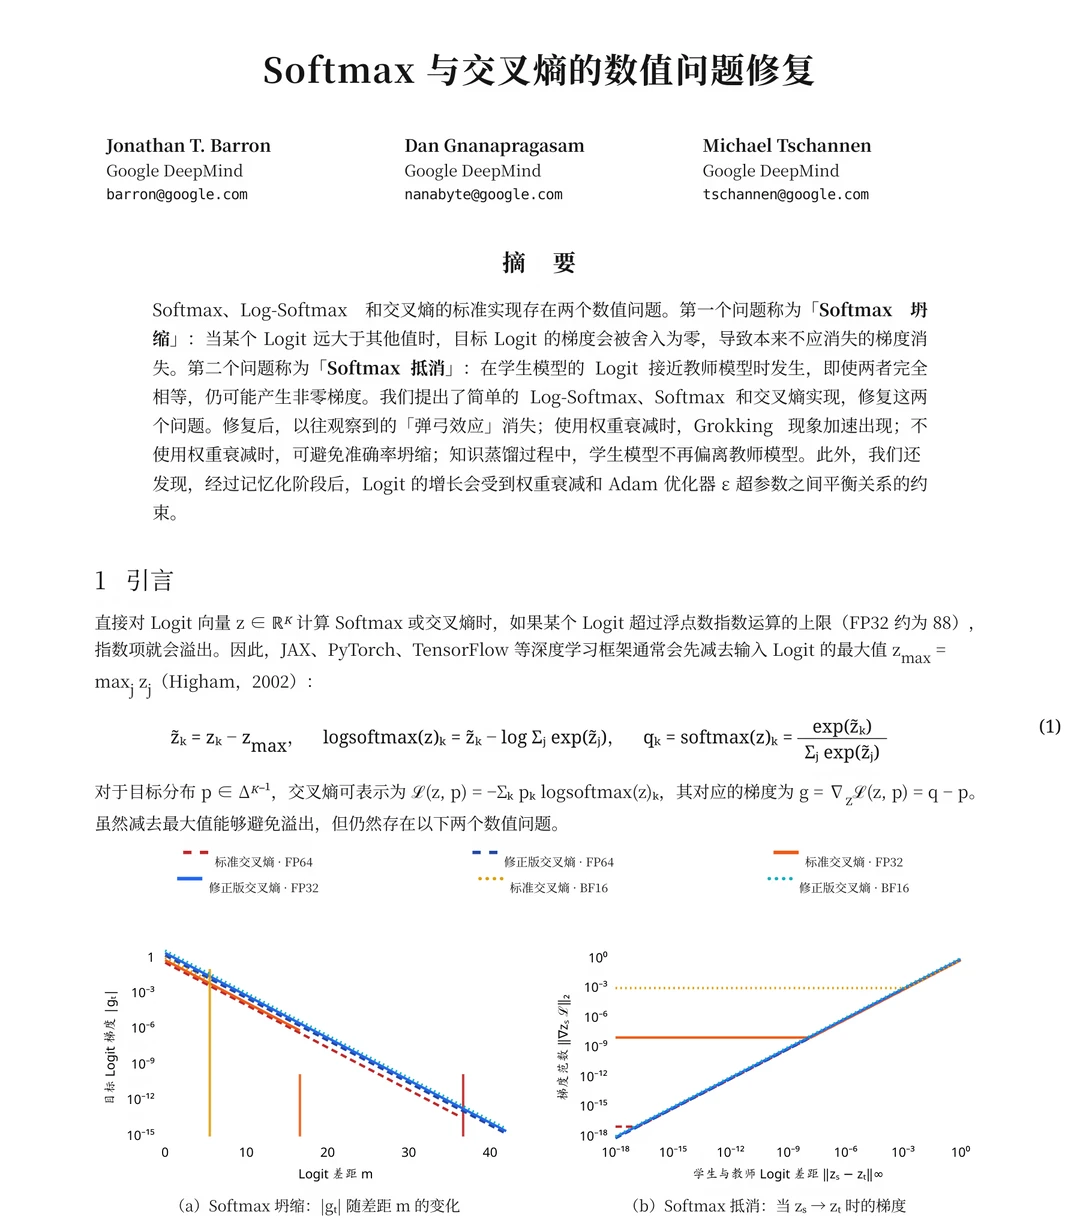
最近,Google DeepMind 发布了一篇要重视的论文《A Fix for Softmax and Cross-Entropy》。
作者发现,我们在训练大模型时经常使用的 Softmax 和交叉熵(Cross-Entropy),竟然存在两个长期被忽略的数值计算问题。而且,这些问题不只是计算结果有一点误差,还可能影响梯度,甚至导致模型训练不稳定。
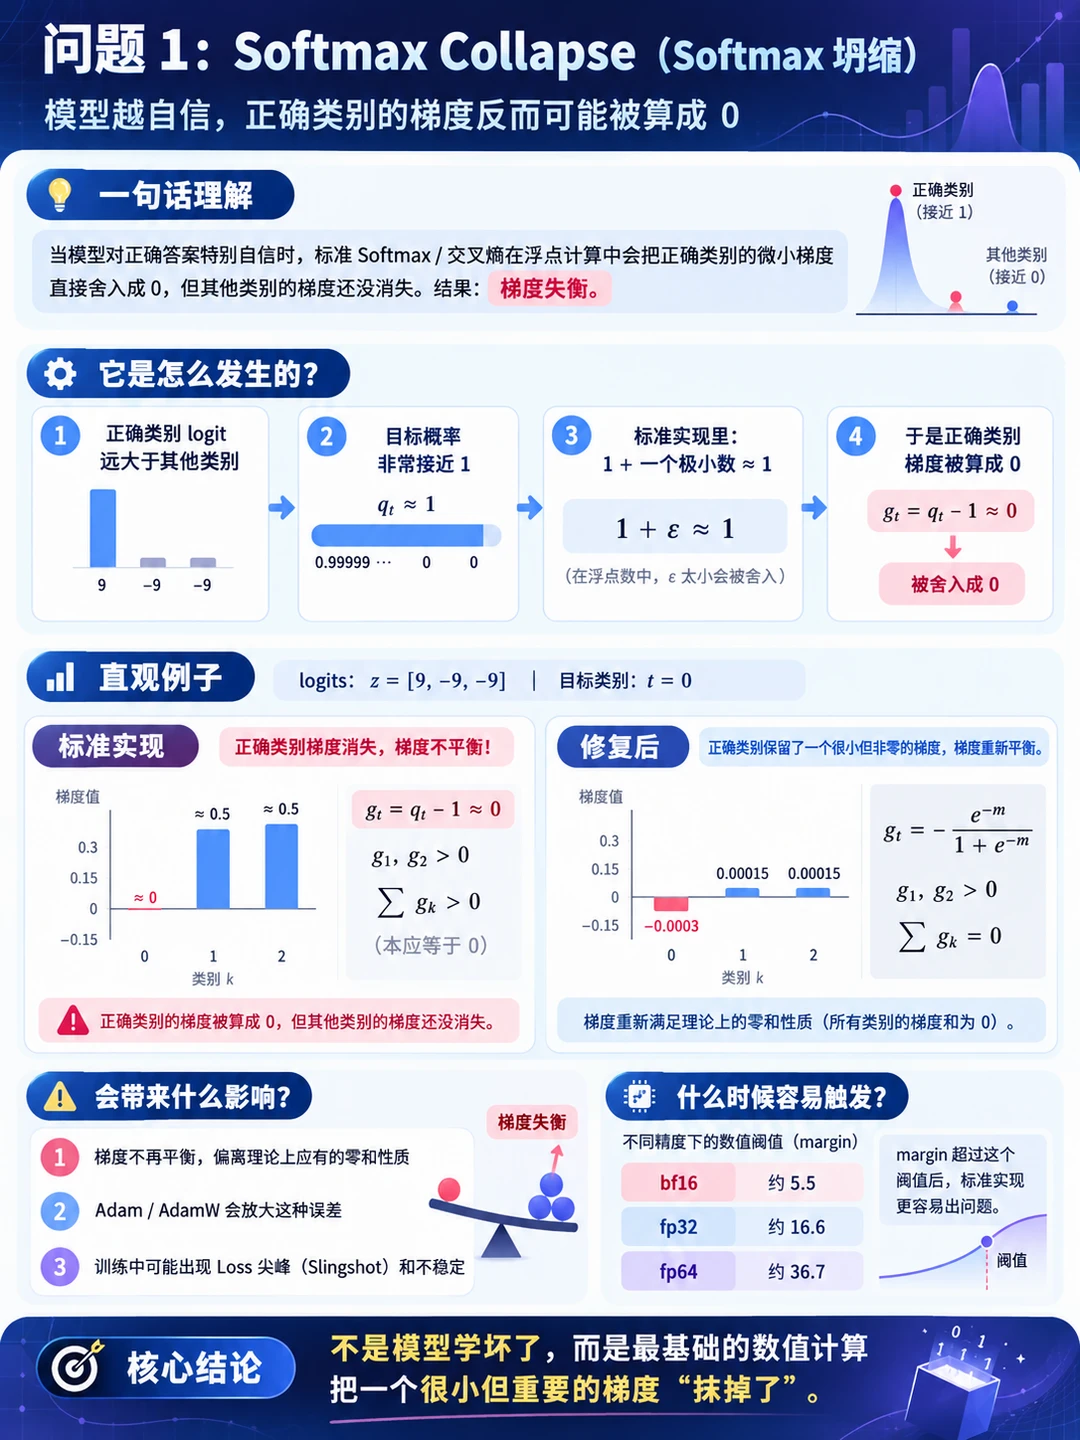
🔵 问题1:模型越自信,梯度反而算错了
大家都知道,Softmax 会把模型输出的分数转换成概率,交叉熵则用来衡量预测和正确答案之间的差距。
正常情况下,即使模型已经非常确定正确答案,仍然应该存在一个很小的梯度,让模型继续优化。
但问题来了!
由于计算机的浮点精度有限,当模型对正确答案过于自信时,这个很小的梯度可能被直接舍入成 0,而其他错误类别的梯度却还在。
这样一来,原本应该相互平衡的梯度就不平衡了。
作者把这个问题叫作 Softmax Collapse(Softmax 坍缩)。
更麻烦的是,Adam 优化器还可能放大这种数值误差,让训练过程中出现突然的 Loss 尖峰。
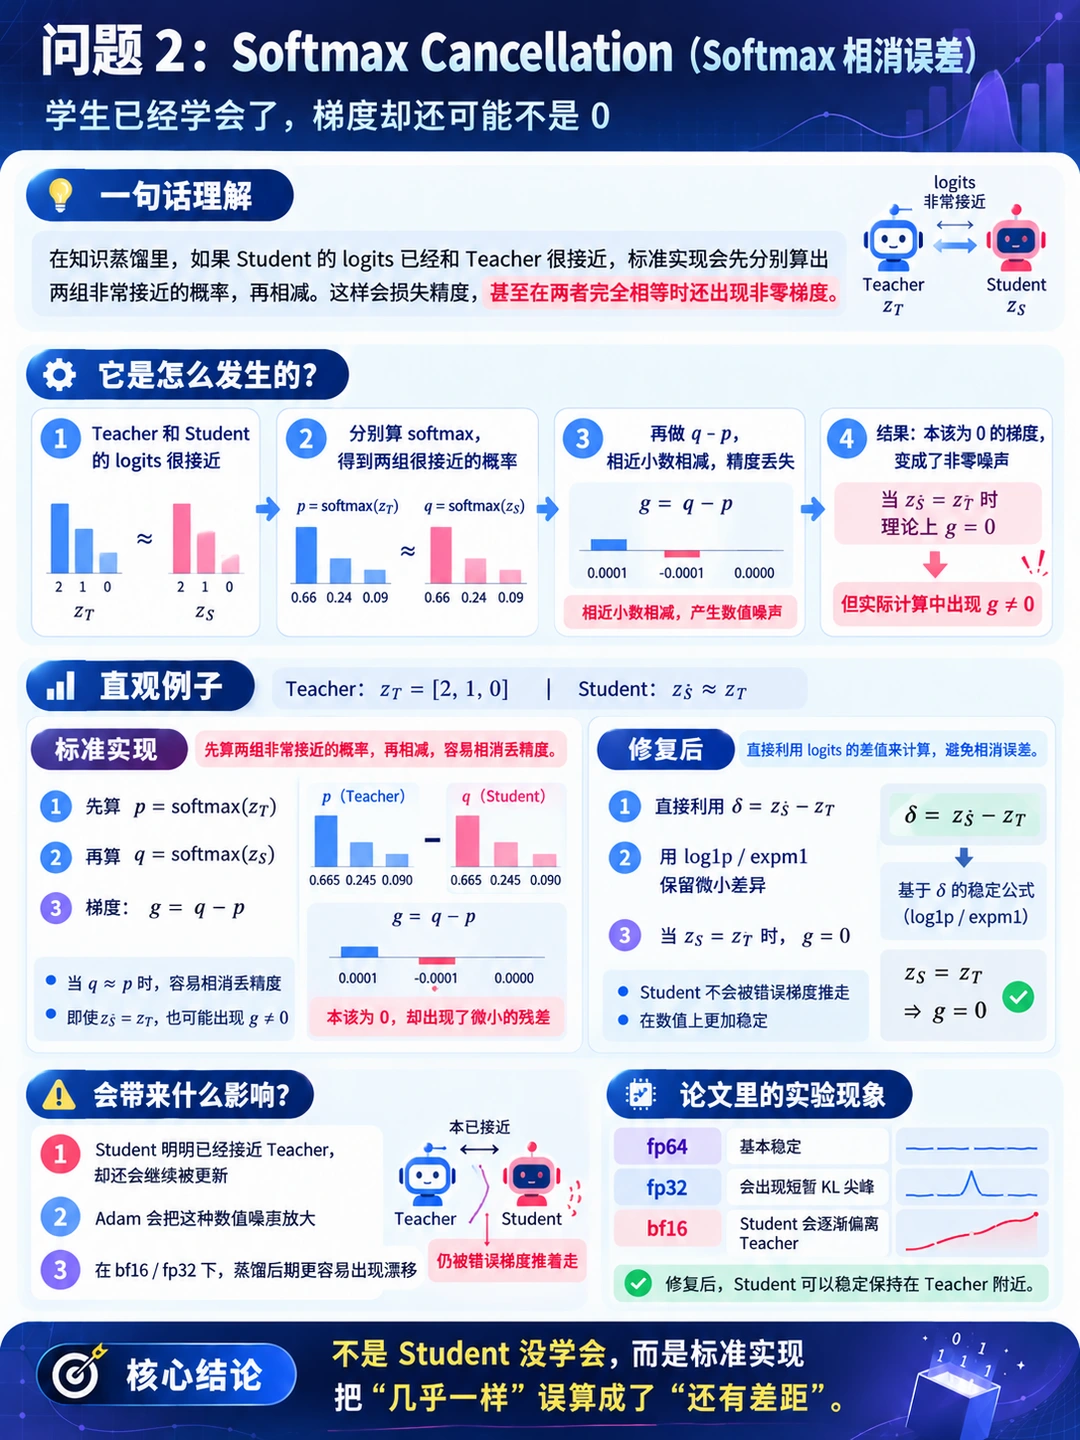
🔵 问题2:学生已经学会了,老师却还让它继续改
这个问题主要出现在知识蒸馏中。
假设有两个模型,一个 Teacher,一个 Student。
Student 的目标就是模仿 Teacher 的输出。
按理说,如果 Student 已经和 Teacher 完全一样,就不应该再产生梯度,模型也不需要继续更新。
但由于浮点计算误差,即使两个模型的输出完全一致,标准交叉熵仍然可能算出非零梯度。
结果就是:Student 明明已经学会了,却还在被错误的梯度推动,反而逐渐偏离 Teacher。
这个问题在 BF16 等低精度计算中尤其明显。
🔵 修复后效果怎么样?
作者重新设计了 Softmax 和交叉熵的数值计算方式,避免那些容易损失精度的操作。
实验结果挺明显:
▪️ 在 Grokking 实验中,原本反复出现的 Loss 尖峰消失了。
▪️ 一组实验中,标准交叉熵让测试准确率从 61% 暴跌到 23%,修复后的版本则平稳提升到 85%。
▪️ 在知识蒸馏实验中,标准 BF16 交叉熵会让 Student 逐渐偏离 Teacher,而修复后可以保持一致,测试准确率稳定在 100%。
▪️ 不需要提高浮点精度,也不需要更换优化器,只需要改进计算方式。
不过,不确定这个实际对大模型的训练影响有多大?