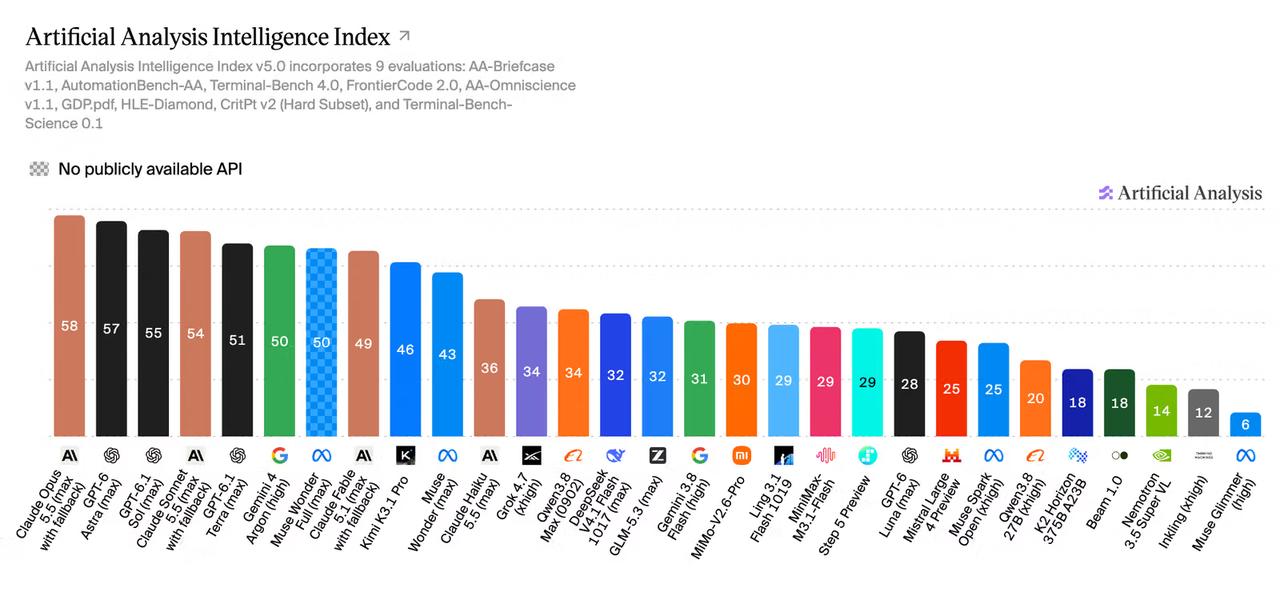
大模型评测榜,刚刚完成了一次对“应试刷题”的清场。
今天,大模型测评机构Artificial Analysis发布了大模型智能指数v5版本。结果,此前一路紧咬硅谷巨头的开源模型,分差瞬间从3分被拉大到12分。
榜首的Claude Opus 5.5和GPT-6 Astra拿到了58和57分,国产开源模型DeepSeek V4.1 Flash和GLM-5.3只拿到32分。这很像是硅谷评测机构在打压中国开源模型。
v5测评最大的变化,是首次将60%的测试建立在完全私有的测试集上,并引入了FrontierCode 2.0和Terminal-Bench-Science两大基准。前者要求AI在真实开源库里改代码,评判标准是项目维护者愿不愿意合并;后者要求AI在终端环境里独立跑完70个科研工作流。
同时我注意到两组极具参考价值的数据:一是v5任务的Token消耗中位数从3.5万暴增到5.9万,智能体评测吃掉了90%的输出量;二是顶级模型单次任务成本相差超过13倍,Claude Opus 5.5要10.04美元,而得分仅差3分的GPT-6.1 Sol只要1.27美元。
这说明大模型的竞争已经彻底告别了“一问一答”的做题家时代,全面转向高算力消耗的Agent工程交付。
但我觉得,这并不能证明国产模型就“刷榜”了,开发者完全没必要陷入非黑即白的站队情绪。我们可以在日常写代码和明确规则的任务中,继续高频调用便宜极速的DeepSeek或GLM,而在极其复杂的系统架构和科研探索上,再去为昂贵的闭源旗舰买单。
未来的技术红利,不属于盲目崇拜榜首分数的看客,而属于那些能用自己写好的工程规范,把廉价模型调教出更好实战效果的聪明人。