Sakana AI研究多智能体自我监督进化
让AI自己教自己,能不能左脚踩右脚上天?Sakana AI最近的一篇研究MASS,真把这事往前推了一大步,而且方法还挺接地气:让AI自己组队打怪,然后复盘学习。
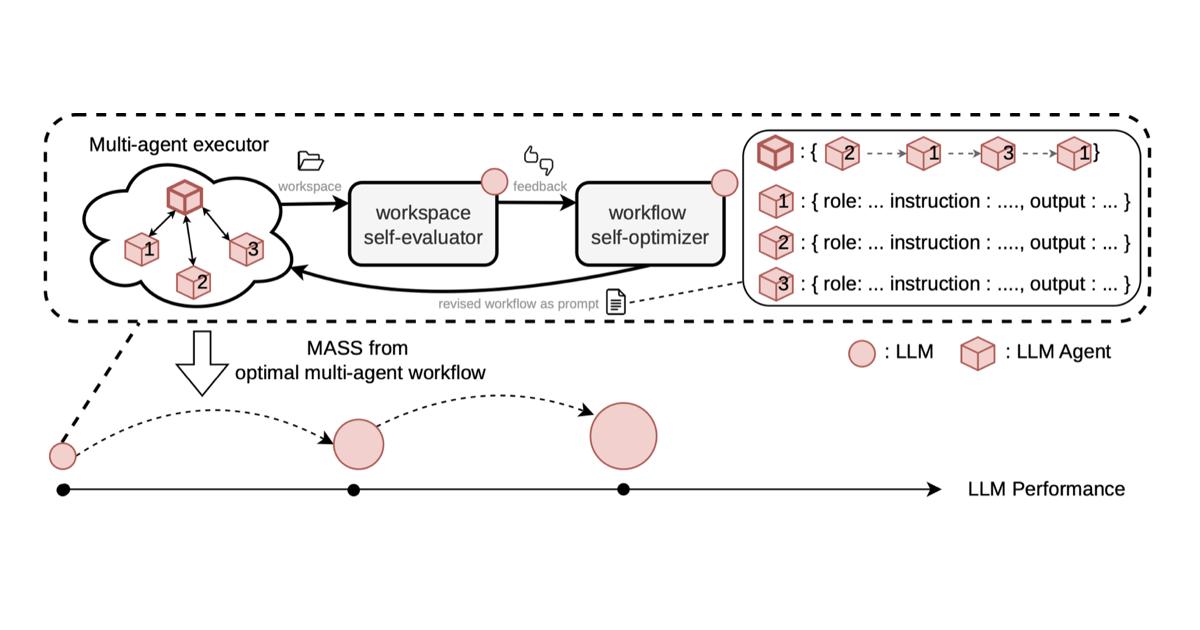
他们搞了个“多智能体自我监督”系统。这里面只有一个基础大模型,但它同时扮演三个角色:执行任务的“执行者”,判断结果好坏的“评估者”,还有专门优化团队工作流程的“优化者”。这就叫“递归自我改进”,自己干活、自己打分、自己想办法优化,完成一轮后,升级版的自己再来一遍。
关键就在“多智能体”这部分。它不是让一个AI死磕一个大任务,而是把它拆分成一个团队,有总控,有分工明确的“子智能体”。团队怎么协作,就靠一份叫“工作流”的剧本。
学习过程分两步。第一步,内部循环:模型固定不变,那个“优化者”AI疯狂实验各种“工作流”剧本,比如调整分工、改变工作顺序、明确交接标准。然后“评估者”AI会判断哪种剧本下,团队产出的结果最好。
第二步,外部循环:用上一步找到的最优剧本,让团队反复执行任务18次,再从里面挑出最好的16次成功案例。然后,用这些案例去微调基础模型。在微调时,他们会把那份“工作流”剧本抽掉。这就逼着模型去理解和内化这种高效的协作方式,而不是只会照本宣科。
结果,经过两轮学习,模型在多个科研任务榜单上的表现,比原始模型高出20%到60%。
有两个比分数更有意思的细节。
第一,AI通过优化工作流,自己领悟到了项目管理的关键:真正重要的不是花哨的“角色”名(比如“数据科学家”),而是清晰的“交付契约”(比如数据不能有未来函数泄漏)和“调用顺序”(先干啥后干啥)。信息被编码进了具体的流程和接口里,而不是模糊的职责描述。
第二,相比让一个AI单打独斗的长篇工作记录,这种多智能体协作的记录是更“密集”的学习信号。也就是说,教AI如何把大任务拆解、协调、整合,比单纯教它怎么一步步做完,学习效率高得多。在消耗了少31%的训练数据后,多智能体训练出的模型反而更强。
对于AI的自我进化,瓶颈可能不是评价能力(判断结果好坏),而是优化能力(改进做事方法)。Sakana的实验也证明,给系统换个更强的“优化者”,比换个更强的“评估者”,效果提升要明显得多。
所以,通向更强AI的有效路径,或许不是让它闭门修炼,而是让它在“社会化”的协作中,学会如何组织和优化自身,从集体智能中涌现出个体能力的飞跃。
AIAgent