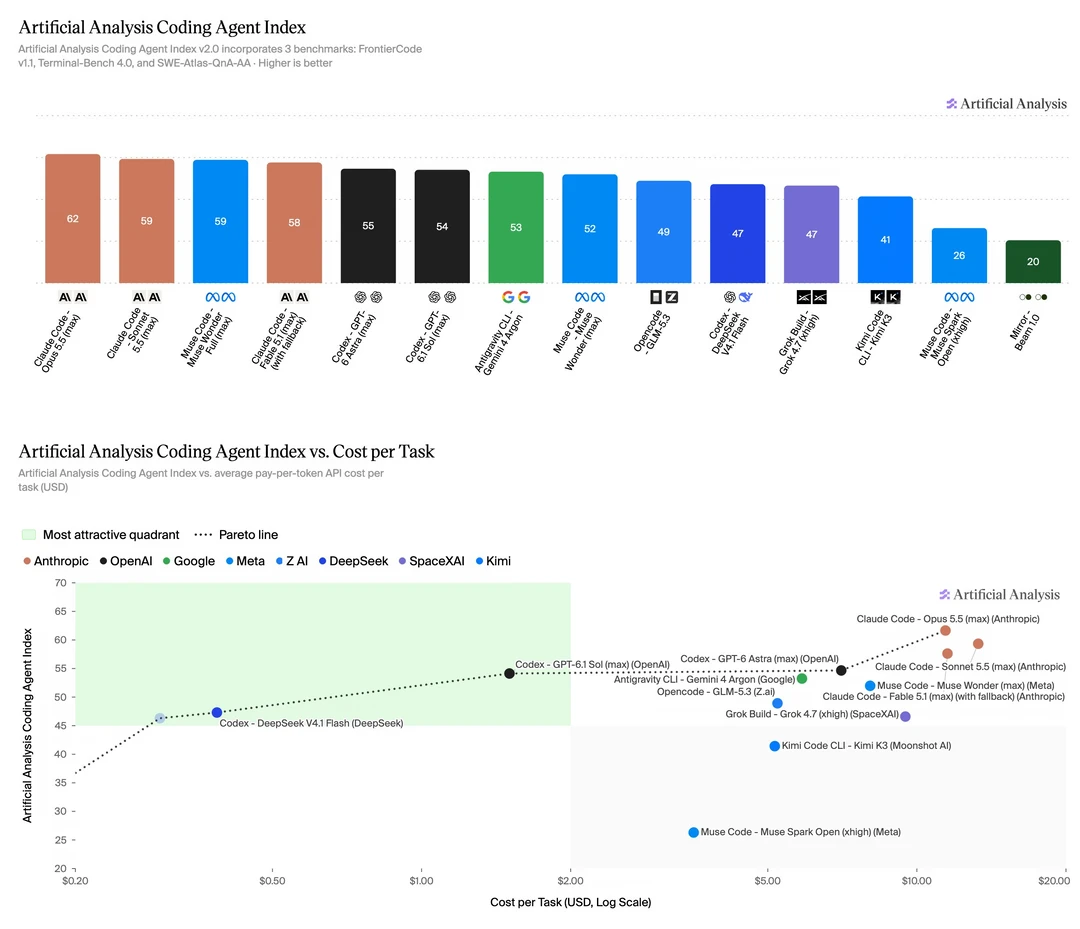
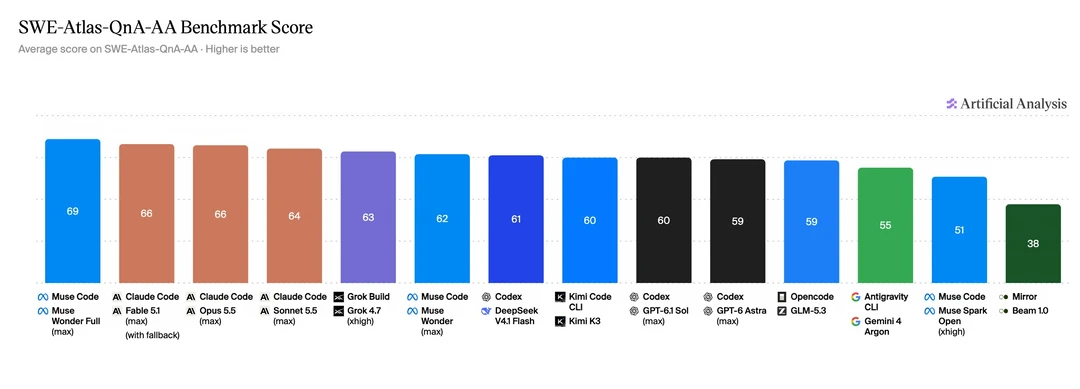
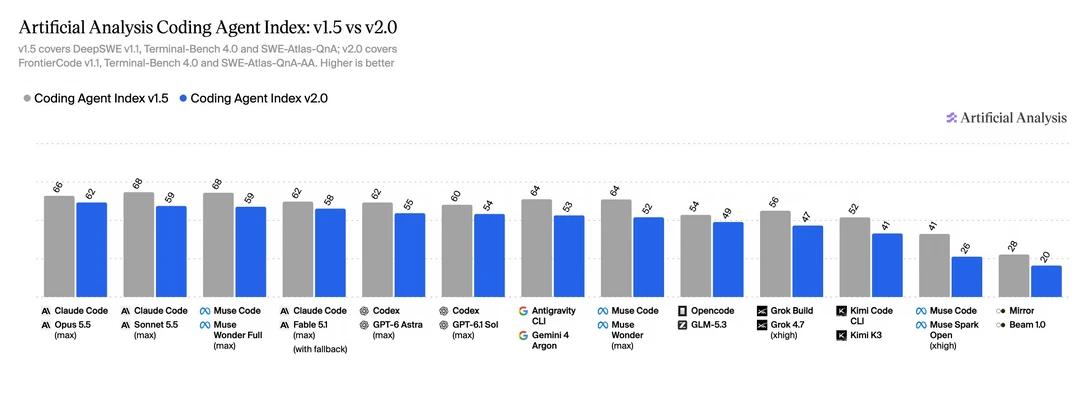
AA 今天发布了 Coding Agent Index v2.0。这次不仅更换了软件工程评测基准,还调整了评分标准,几乎所有模型的分数都下降了。
📌 1. Opus 5.5 依然第一
最新综合排名:
🔹 Claude Opus 5.5:61.7 分
🔹 Claude Sonnet 5.5:59.3 分
🔹 Muse Wonder Full:58.9 分
🔹 Claude Fable 5.1:57.6 分
🔹 GPT-6 Astra:54.7 分
🔹 GPT-6.1 Sol:54.1 分
评测对象是模型与 Agent 框架的组合,涵盖软件工程、终端操作和代码仓库问答三个方向,权重相同。
📌 2. 新增 FrontierCode,更接近真实开发
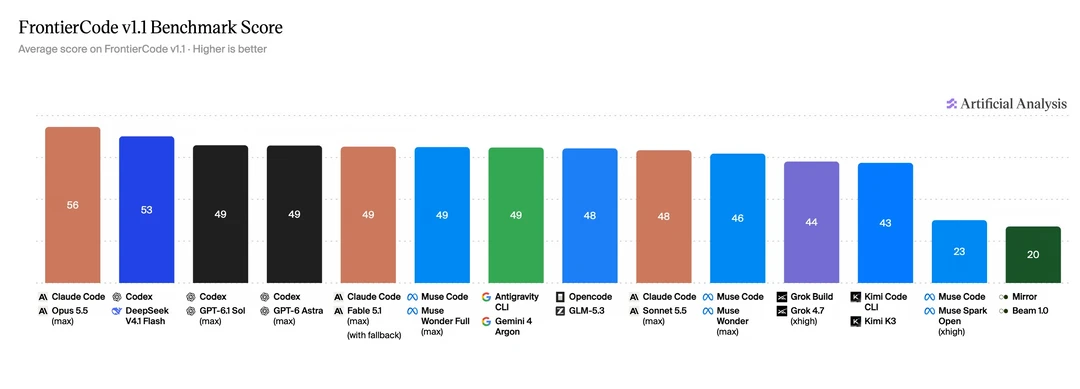
这次用 Cognition 的 FrontierCode v1.1 替换了 DeepSWE。
新基准包含 100 道真实开源项目的软件工程任务,核心标准是:Agent 写的代码,项目维护者愿不愿意合并?
最新成绩:
🔹 Claude Opus 5.5:56.0%
🔹 DeepSeek V4.1 Flash:52.6%
🔹 GPT-6.1 Sol:49.4%
🔹 GPT-6 Astra:49.3%
DeepSeek 在这个单项中排名第二,超过了 GPT-6.1 Sol 和 Astra,但综合榜只有 47.3 分。
📌 3. 几乎所有模型分数下降
同时参与新旧版本评测的 21 个配置中,20 个得分下降。
🔹 v1.5 平均分:54.8
🔹 v2.0 平均分:47.4
主要原因是新基准更难:原来 DeepSWE 的平均分是 65.6%,换成 FrontierCode 后只有 45.1%。
代码仓库问答也调整了评分标准,改用 GPT-6 Luna(xhigh)作为裁判,平均分下降 1.7 个百分点。
📌 4. DeepSeek 成本优势明显
平均单任务 API 成本:
🔹 DeepSeek V4.1 Flash:47.3 分,$0.39
🔹 GPT-6.1 Sol:54.1 分,$1.50
🔹 GPT-6 Astra:54.7 分,$7.04
🔹 Claude Opus 5.5:61.7 分,$11.42
这四个配置位于成本与性能的最优前沿。
Opus 5.5 综合能力最强,但单任务成本接近 DeepSeek 的 29 倍。
#大模型