DeepSeek V4.1-Flash-1017 这次更新,比较值得关注的是编程能力。
我看了一下第三方网站 AI-Leaderboard.dev 的最新榜单,DeepSeek V4.1 Flash 1017 的表现确实不错。
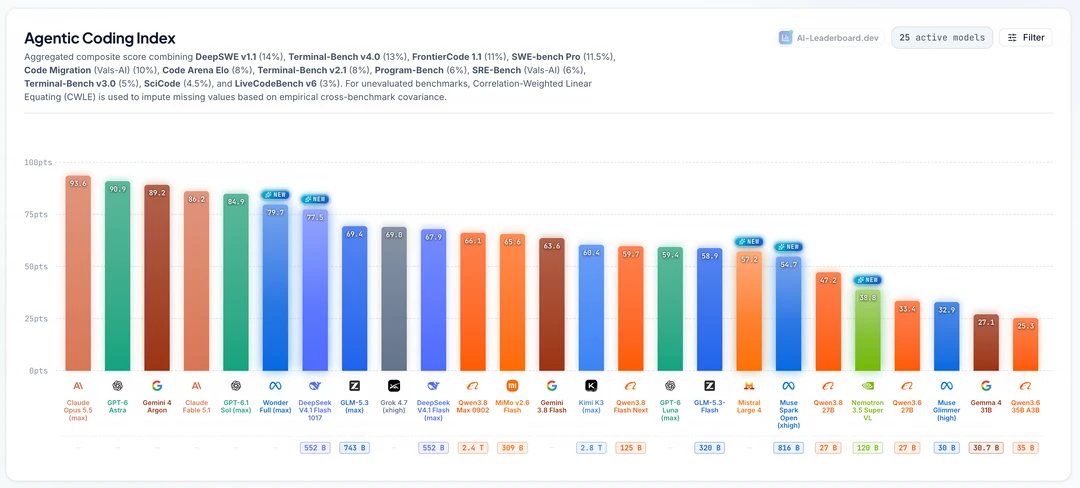
📌 Agentic Coding Index:编程能力国产第一
这个榜单不是单独看 SWE-bench,而是综合了 DeepSWE v1.1、Terminal-Bench、SWE-bench Pro、FrontendCode 等 12 项编程评测,更侧重 Agent 实际完成复杂编程任务的能力。
最新排名:
🔹 Claude Opus 5.5:93.6 分
🔹 GPT-6 Astra:90.9 分
🔹 Gemini 4 Argon:89.2 分
🔹 Claude Fable 5.1:86.2 分
🔹 GPT-6.1 Sol:84.9 分
🔹 Muse Wonder Full:79.7 分
🔹 DeepSeek V4.1 Flash 1017:77.5 分
🔹 GLM-5.3:69.4 分
🔹 Grok 4.7:69.0 分
🔹 DeepSeek V4.1 Flash 旧版:67.9 分
新版相比旧版直接提升了 9.6 分,排名全球第 7、国产第 1。
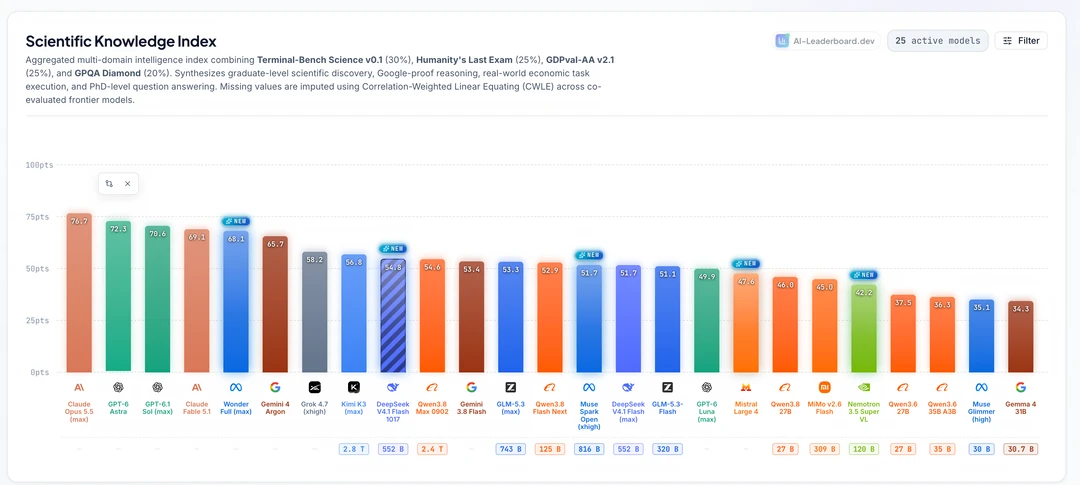
📌 Scientific Knowledge Index:科学知识能力也有提升
这个榜单综合了 Terminal-Bench Science、Humanity's Last Exam、GDPval-AA、GPQA Diamond 四项评测,涉及科学研究、知识推理等能力。
DeepSeek V4.1 Flash 1017 拿到了 54.8 分,排名全球第 9、国产第 2,相比旧版的 51.7 分提升了 3.1 分。在国产模型中,仅次于 Kimi K3 的 56.8 分。
📌 为什么这次不叫 DeepSeek V4.2 Flash?
值得一提的是,新版的参数规模依然是 552B。这次提升主要来后训练优化,而不是进一步扩大模型规模。
有人觉得,这次编程能力提升这么明显,完全可以叫 DeepSeek V4.2 Flash 了。
但按照 DeepSeek 以往的版本命名习惯,同一模型架构和参数规模下的训练迭代,通常还是沿用原来的版本号,通过日期后缀来区分。
有点期待 DeepSeek V4.1 Pro,估计能够真正接近国外 SOTA 模型了。
#大模型 #DeepSeek