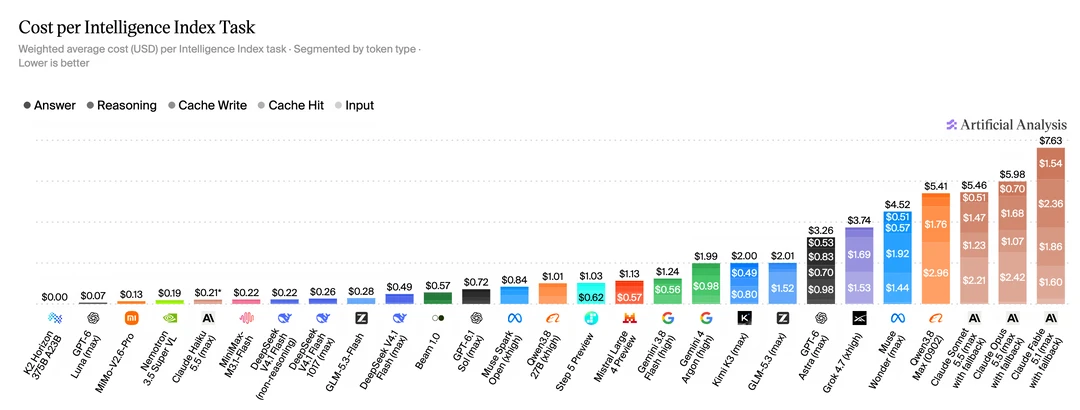
刚才看了一下,DeepSeek V4.1 Flash 1017 的 Artificial Analysis(AA)评测结果终于出来了。
这次升级还是比较明显的,尤其是智能水平提升了不少。
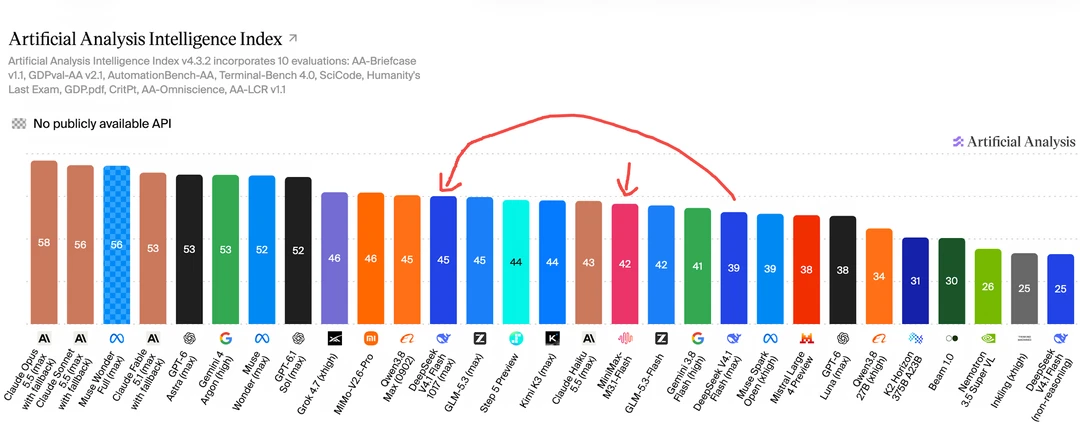
📌 1. 智能指数:39 → 45 分,提升 6 分
在最新的 AA Intelligence Index v4.3.2 榜单中:
🔹 DeepSeek V4.1 Flash(旧版):39 分
🔹 DeepSeek V4.1 Flash 1017:45 分
新版本提升了 6 分,增幅约 15.4%。
目前已经追平 GLM-5.3、Qwen3.8-Max,超过 MiniMax M3.1(42 分),距离 Grok 4.7(46 分)只差 1 分。
不过,距离第一梯队还有一定差距:
🔹 Claude Opus 5.5:58 分
🔹 Claude Sonnet 5.5:56 分
🔹 GPT-6 Astra:53 分
🔹 Gemini 4 Argon:53 分
🔹 GPT-6 Sol:52 分
我个人感觉这个成绩还是略低于预期的,可能是 AA 的可靠性也没那么好。
📌 2. Token 消耗:基本没有增加
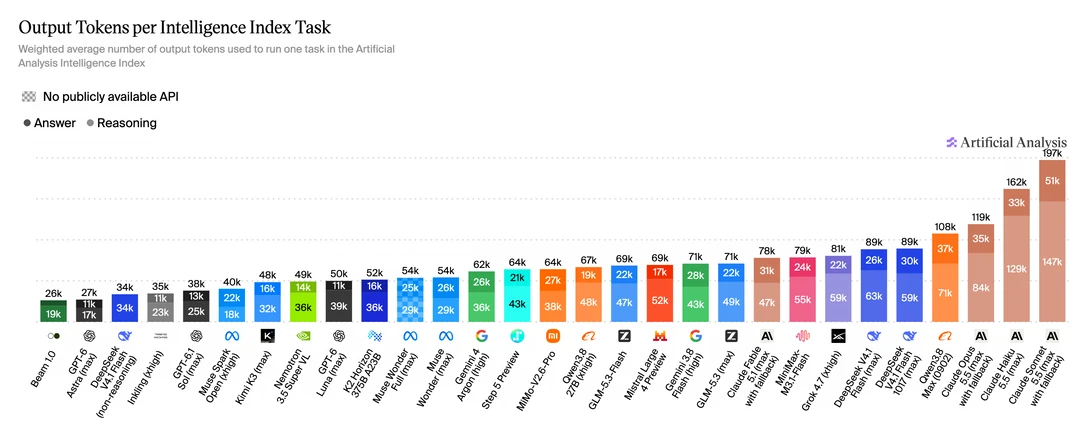
同一套 Intelligence Index 任务所消耗的输出 Token:
🔹 旧版:约 89K Token
🔹 1017 新版:约 89K Token
也就是说,新版在总输出 Token 基本不变的情况下,智能指数提升了 6 分。
从结构来看,推理 Token 从约 63K 降到 59K,而答案 Token 从 26K 增加到 30K。
说明新版并不是简单地通过增加推理长度来提升成绩。
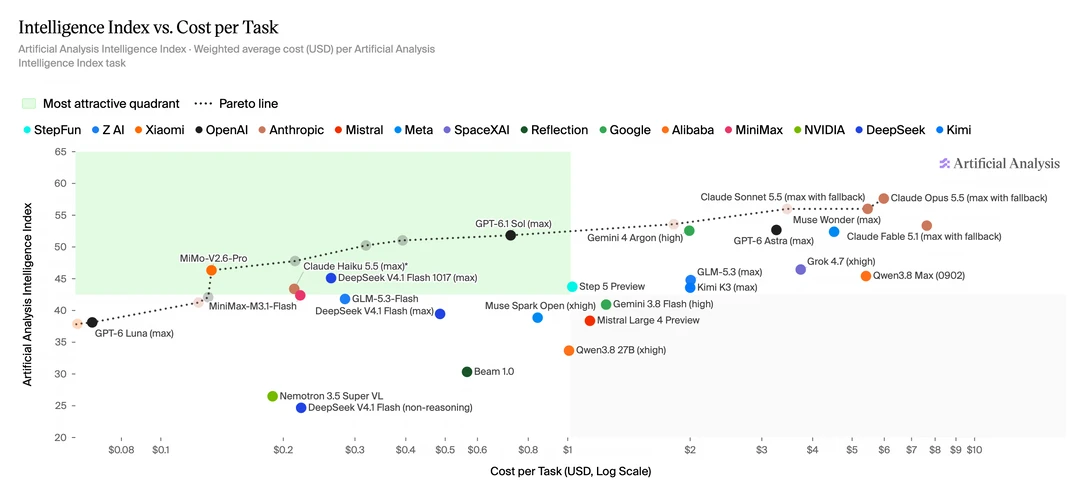
📌 3. 任务成本:0.49 → 0.26 美元,下降约 47%
这可能是 DeepSeek 最大的优势。
完成同一套 AA 评测任务:
🔹 DeepSeek 旧版:0.49 美元
🔹 DeepSeek 1017:0.26 美元
🔹 GLM-5.3:2.01 美元
🔹 GPT-6 Sol:0.72 美元
🔹 GPT-6 Astra:3.26 美元
尤其是与 GLM-5.3 相比,两者智能指数同为 45 分,但 DeepSeek 的任务成本只有它的约八分之一。
不过这里,平均输出 token 并没有变,单价也没有变,但是成本下降,也是有点神奇。(可能是缓存命中)
你觉得这个评测符合你的预期吗?
#大模型 #DeepSeek