AnyFlow学习任意时间转移
📄 AnyFlow: Any-Step Video Diffusion Model with On-Policy Flow Map Distillation
👥 Yuchao Gu、Guian Fang、Yuxin Jiang 等
🏛️ NVIDIA / 新加坡国立大学 / MIT
📅 2026-05-13 / arXiv:2605.13724
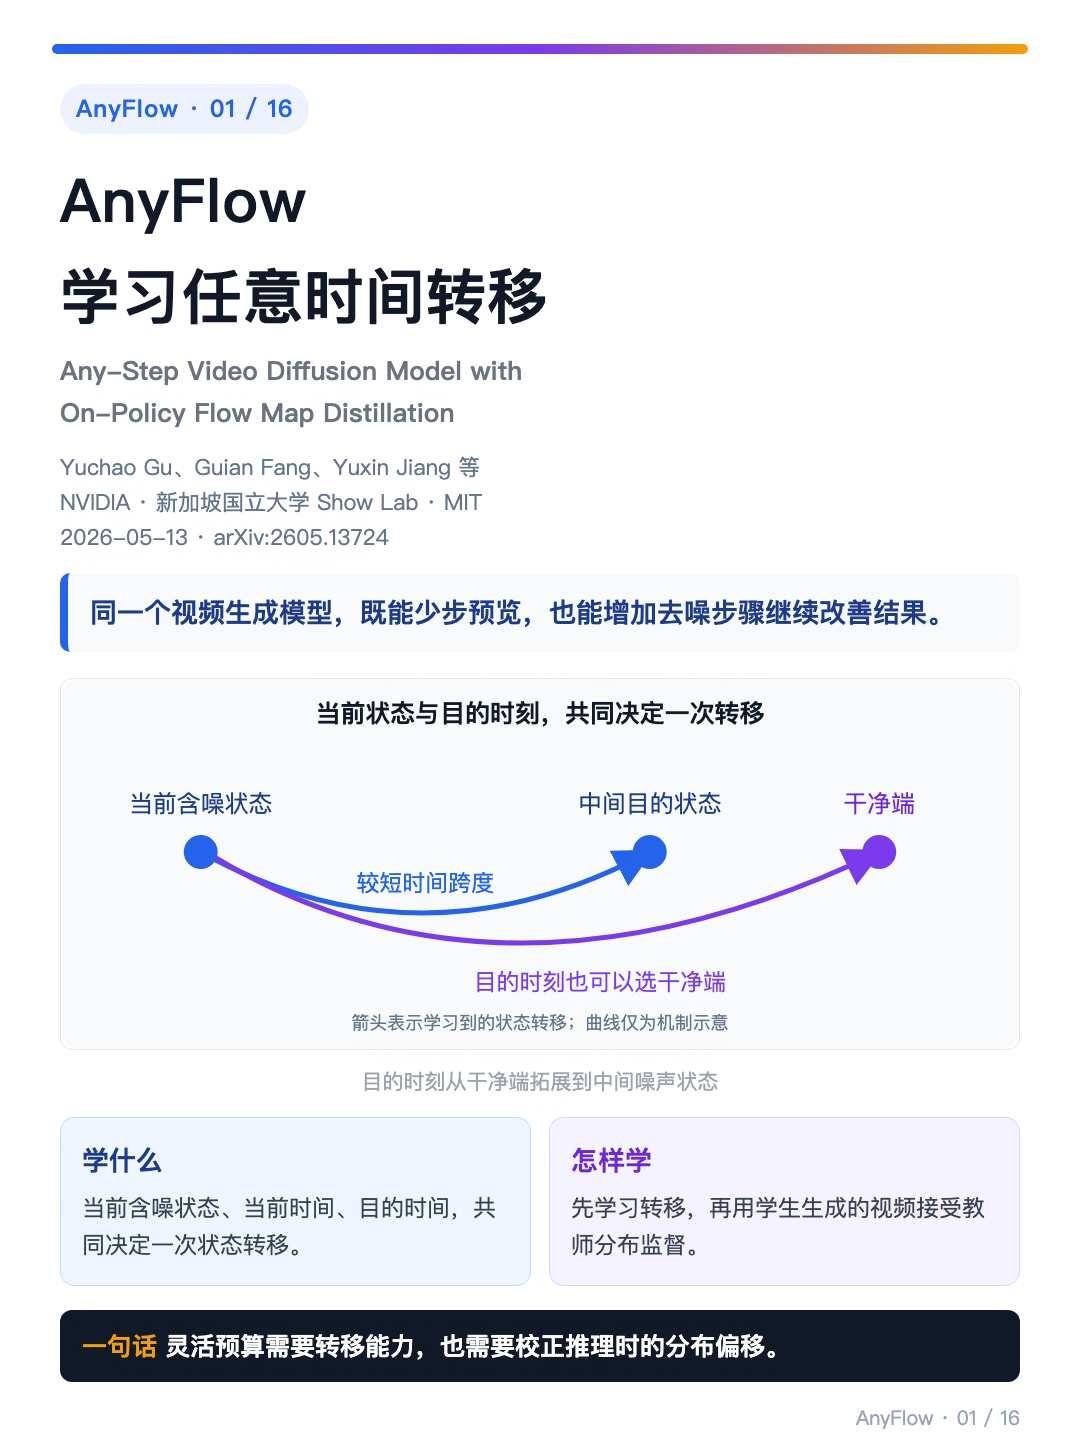
少步预览与多步精细生成,能否共用一个模型?AnyFlow学习从当前噪声时刻到指定较低噪声时刻的状态转移,让目的时刻也成为输入。
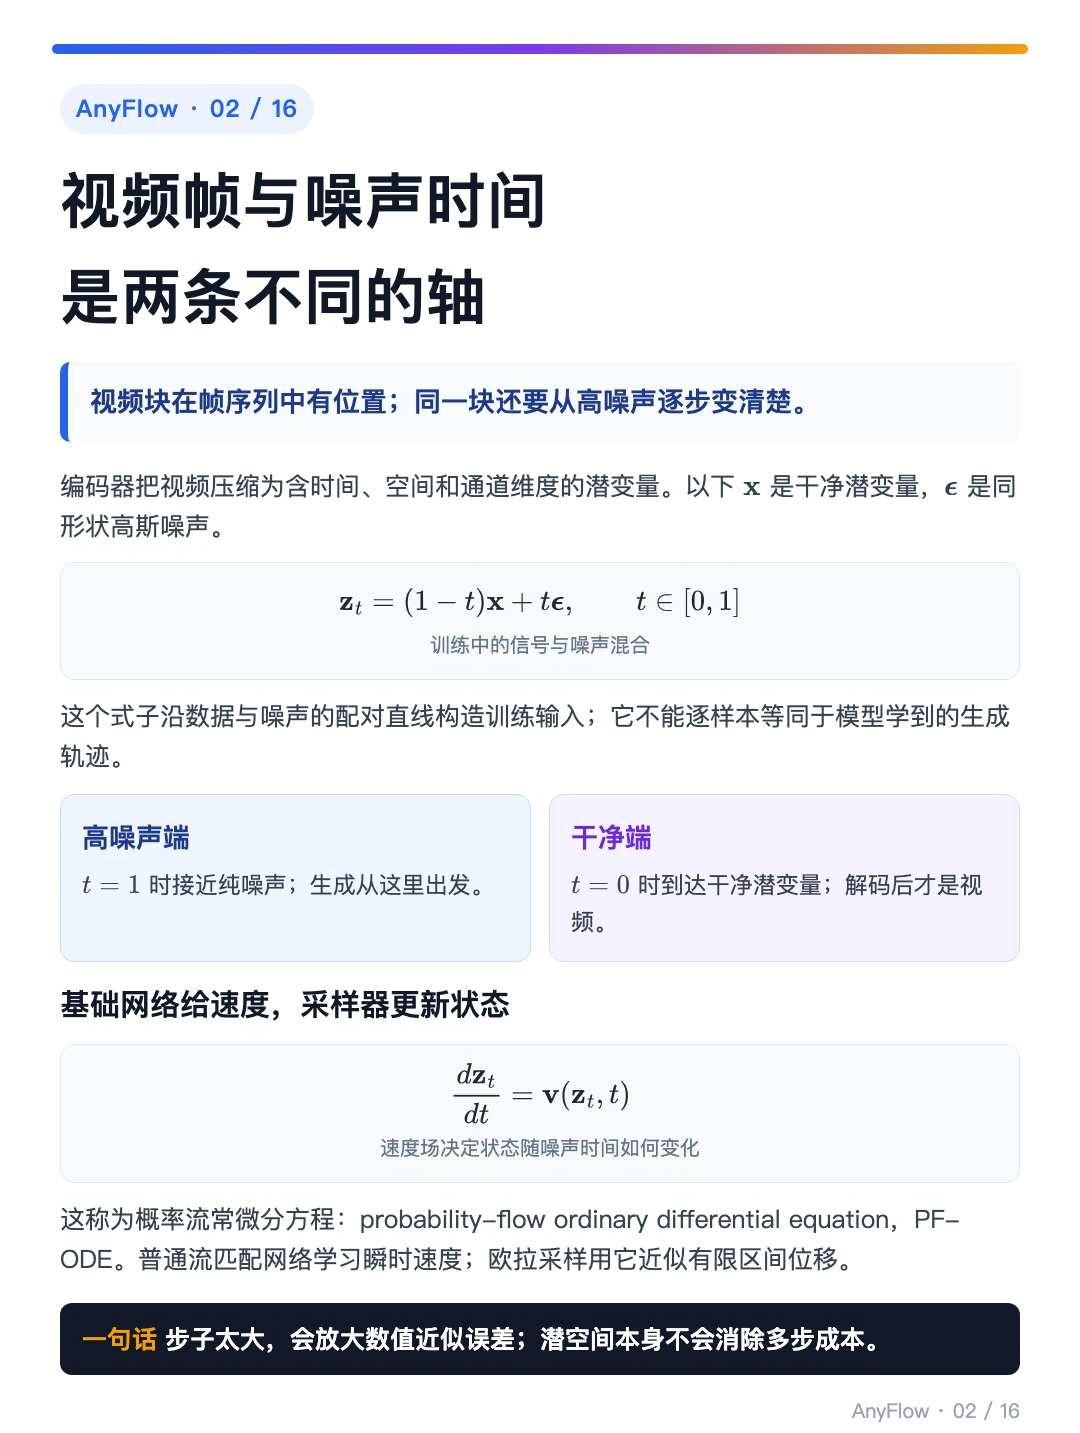
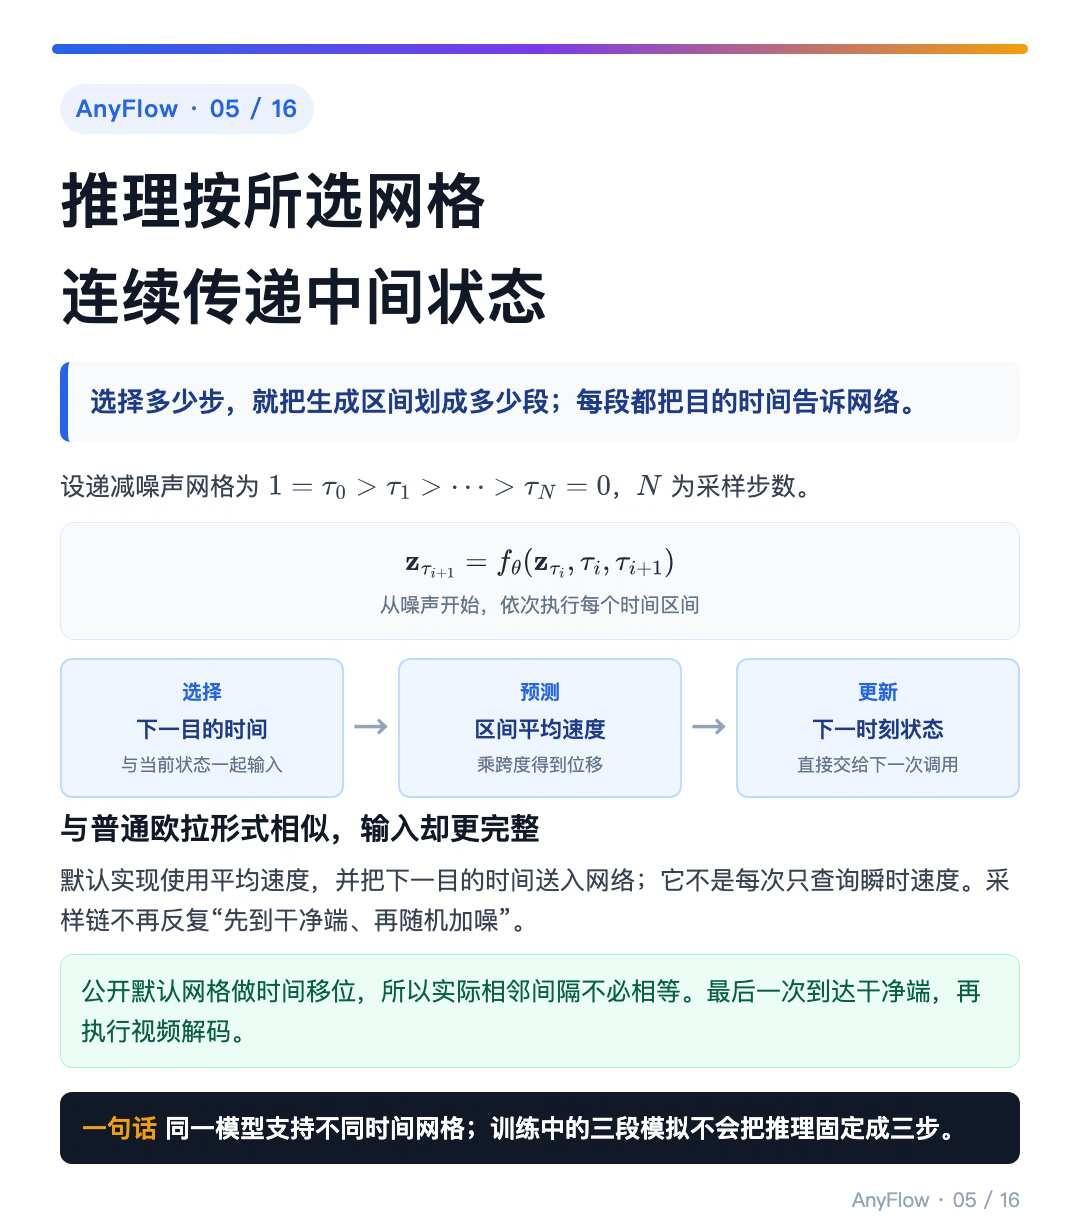
先分清两种时间:视频帧沿时间排列,去噪过程另有噪声时间。普通一致性模型预测干净终点,多步时常需重新加噪;AnyFlow则直接把一次转移后的状态交给下一步。
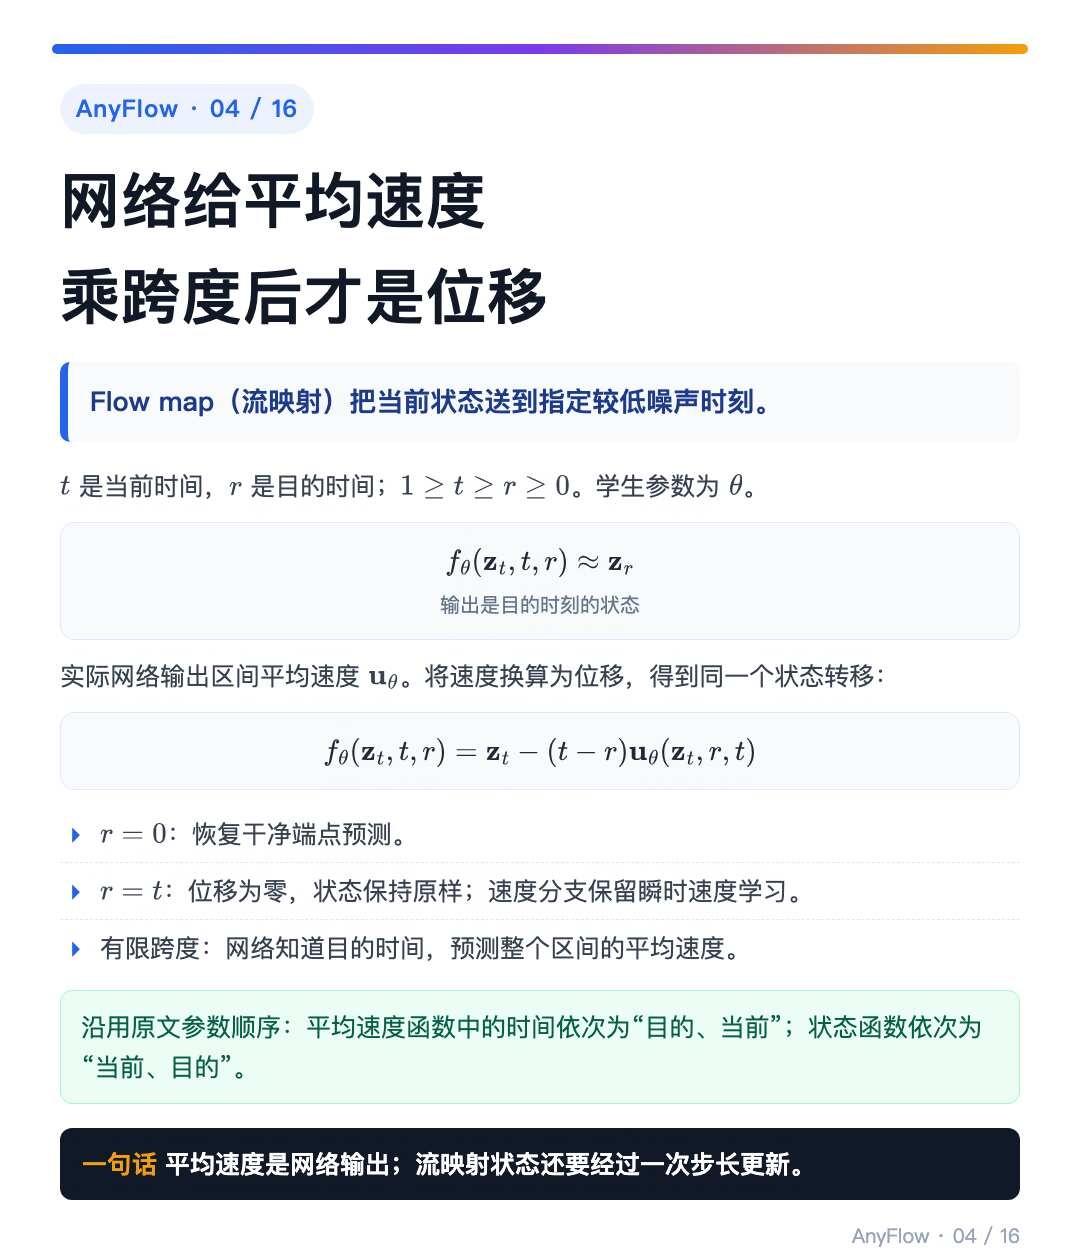
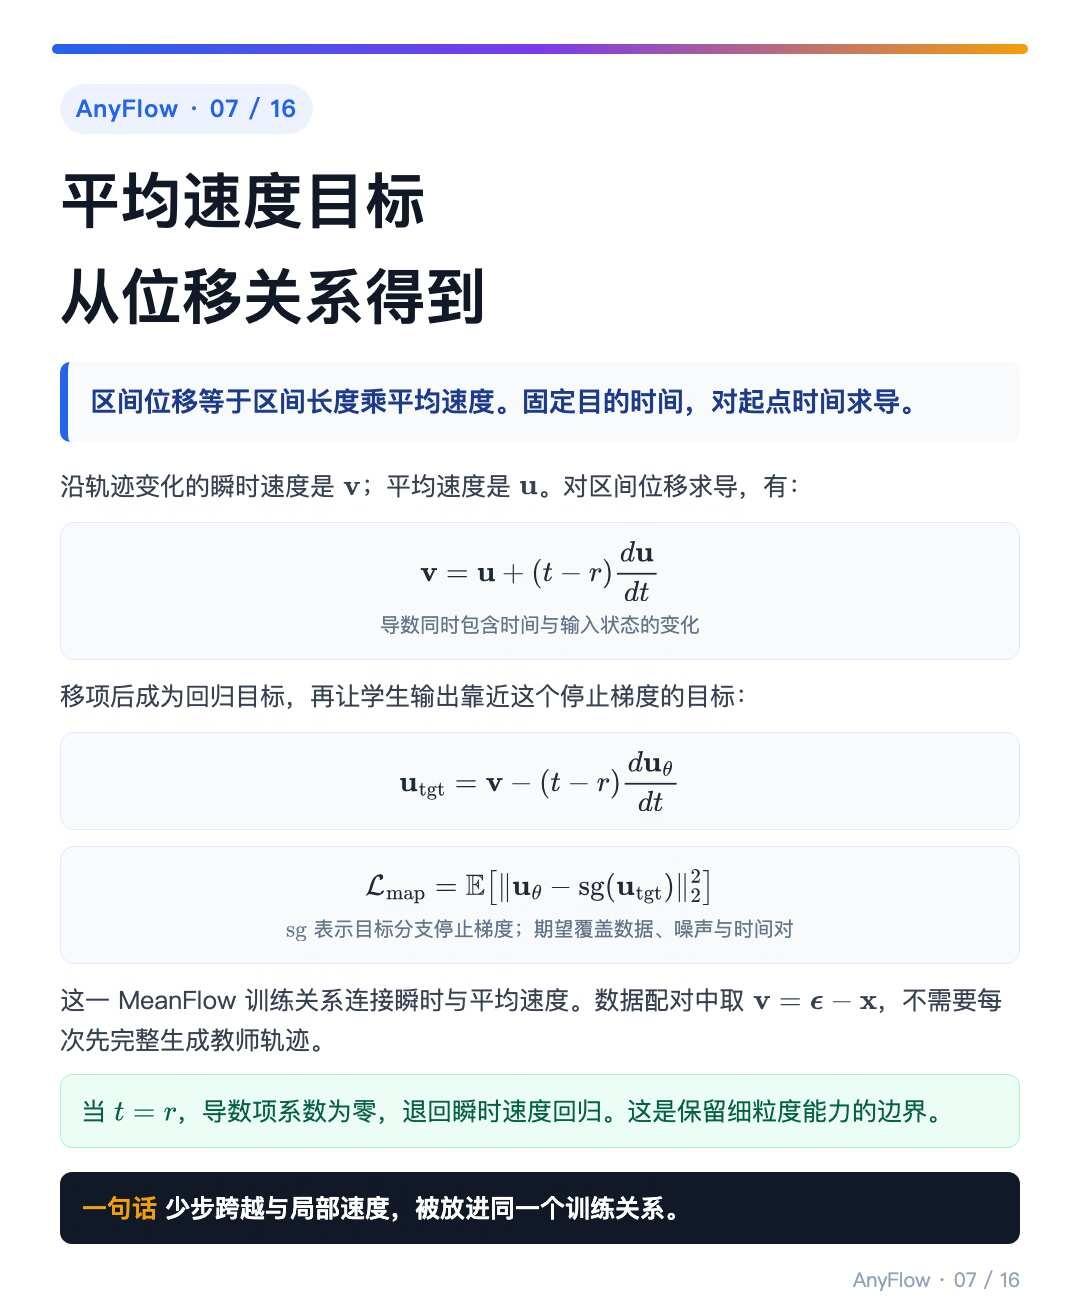
网络实际预测区间平均速度,再乘时间跨度得到位移。目的时刻为零时是终点预测;区间缩到零时保留瞬时速度训练。
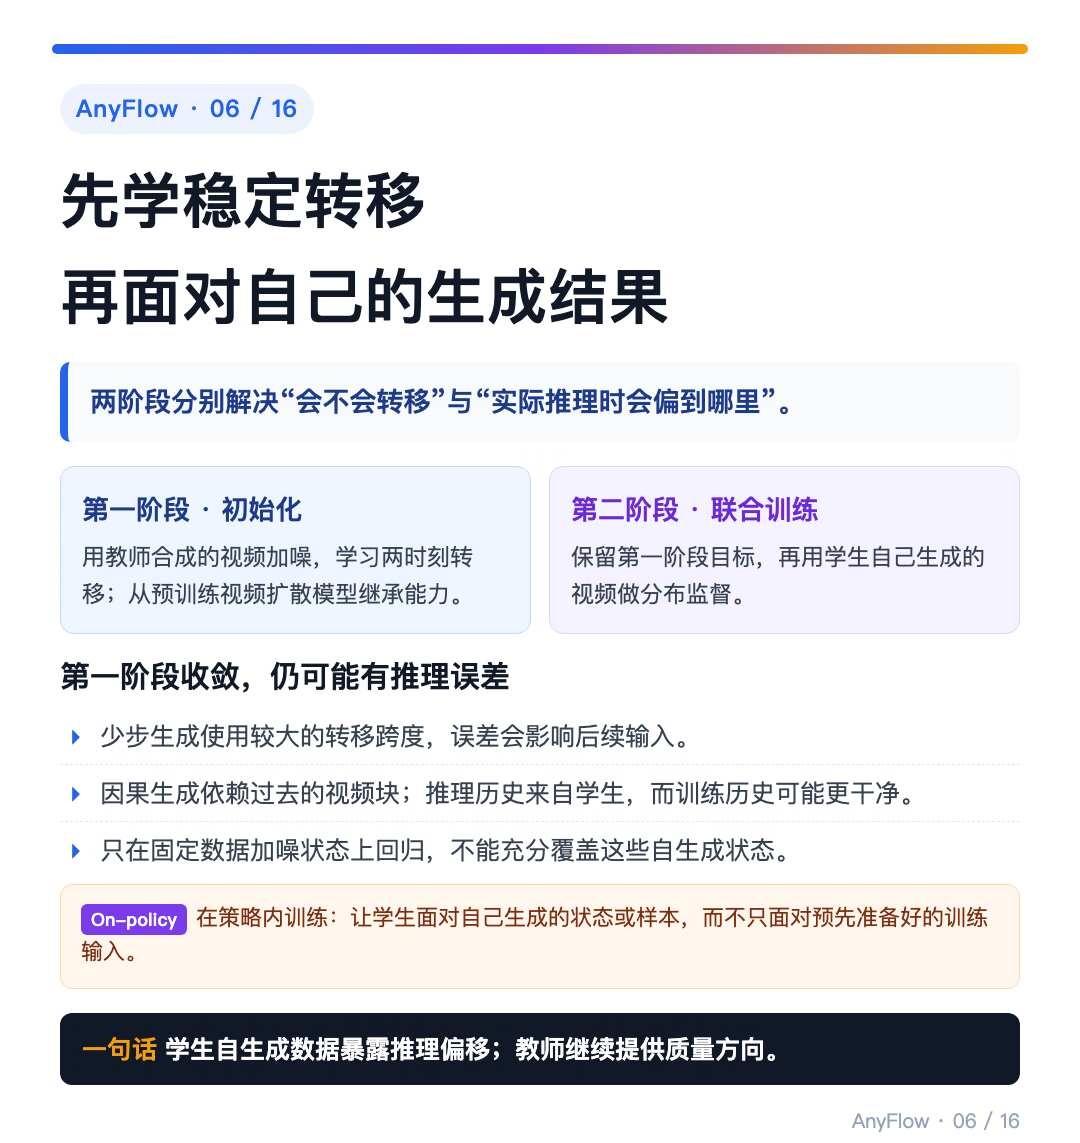
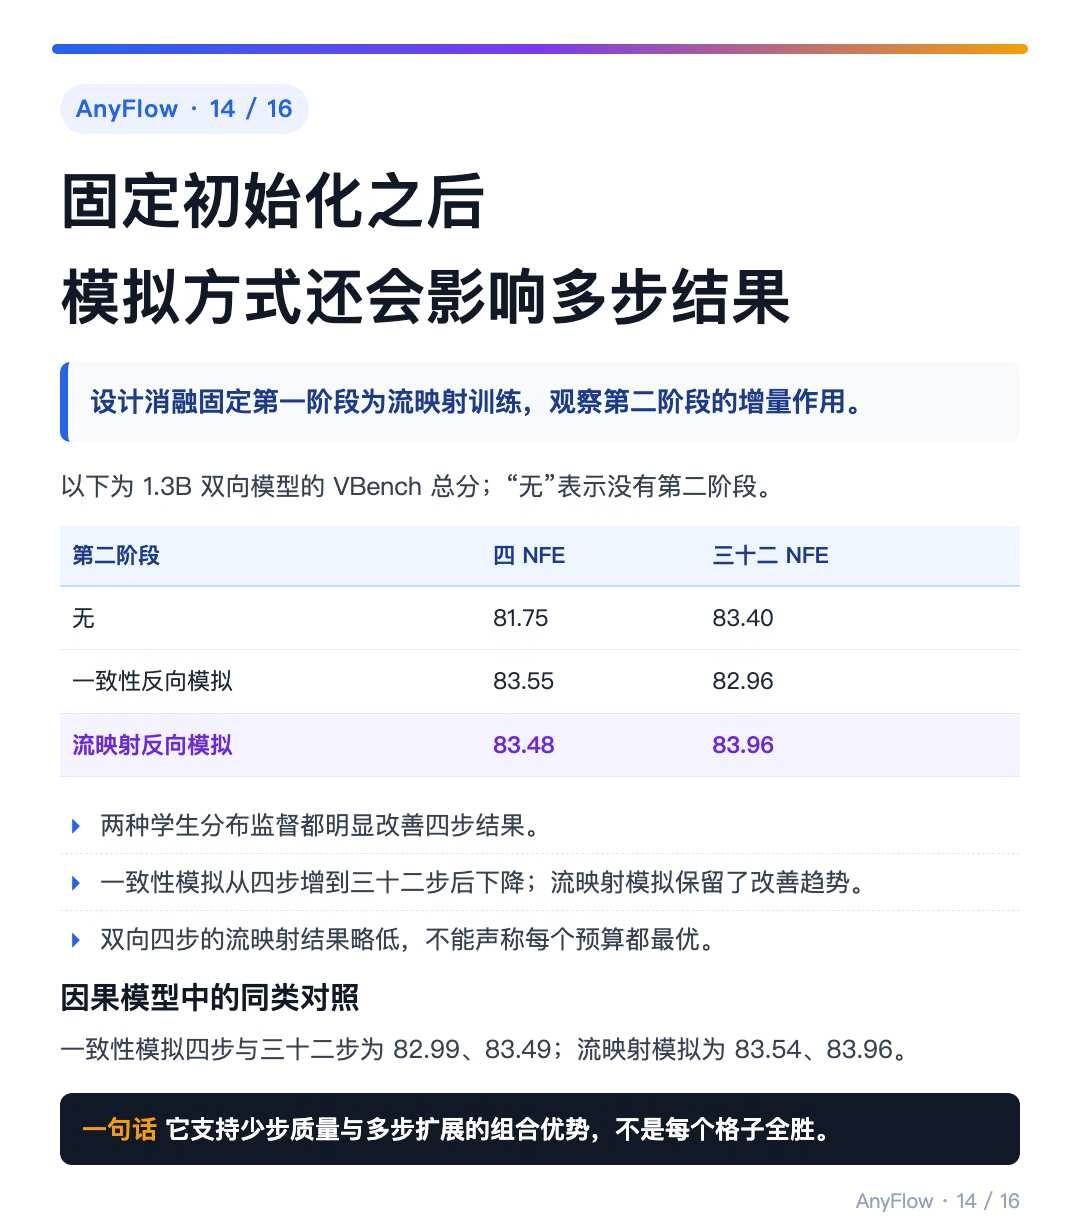
训练先用教师合成视频学习转移,再让学生自己生成视频接受分布监督。第二阶段保留前向训练,并把长采样链压成“前缀捷径—所选相邻转移—后缀捷径”,沿三段反传。三段是训练模拟方式,推理并非固定三步;学习到的捷径也不是精确复现全部欧拉小步。
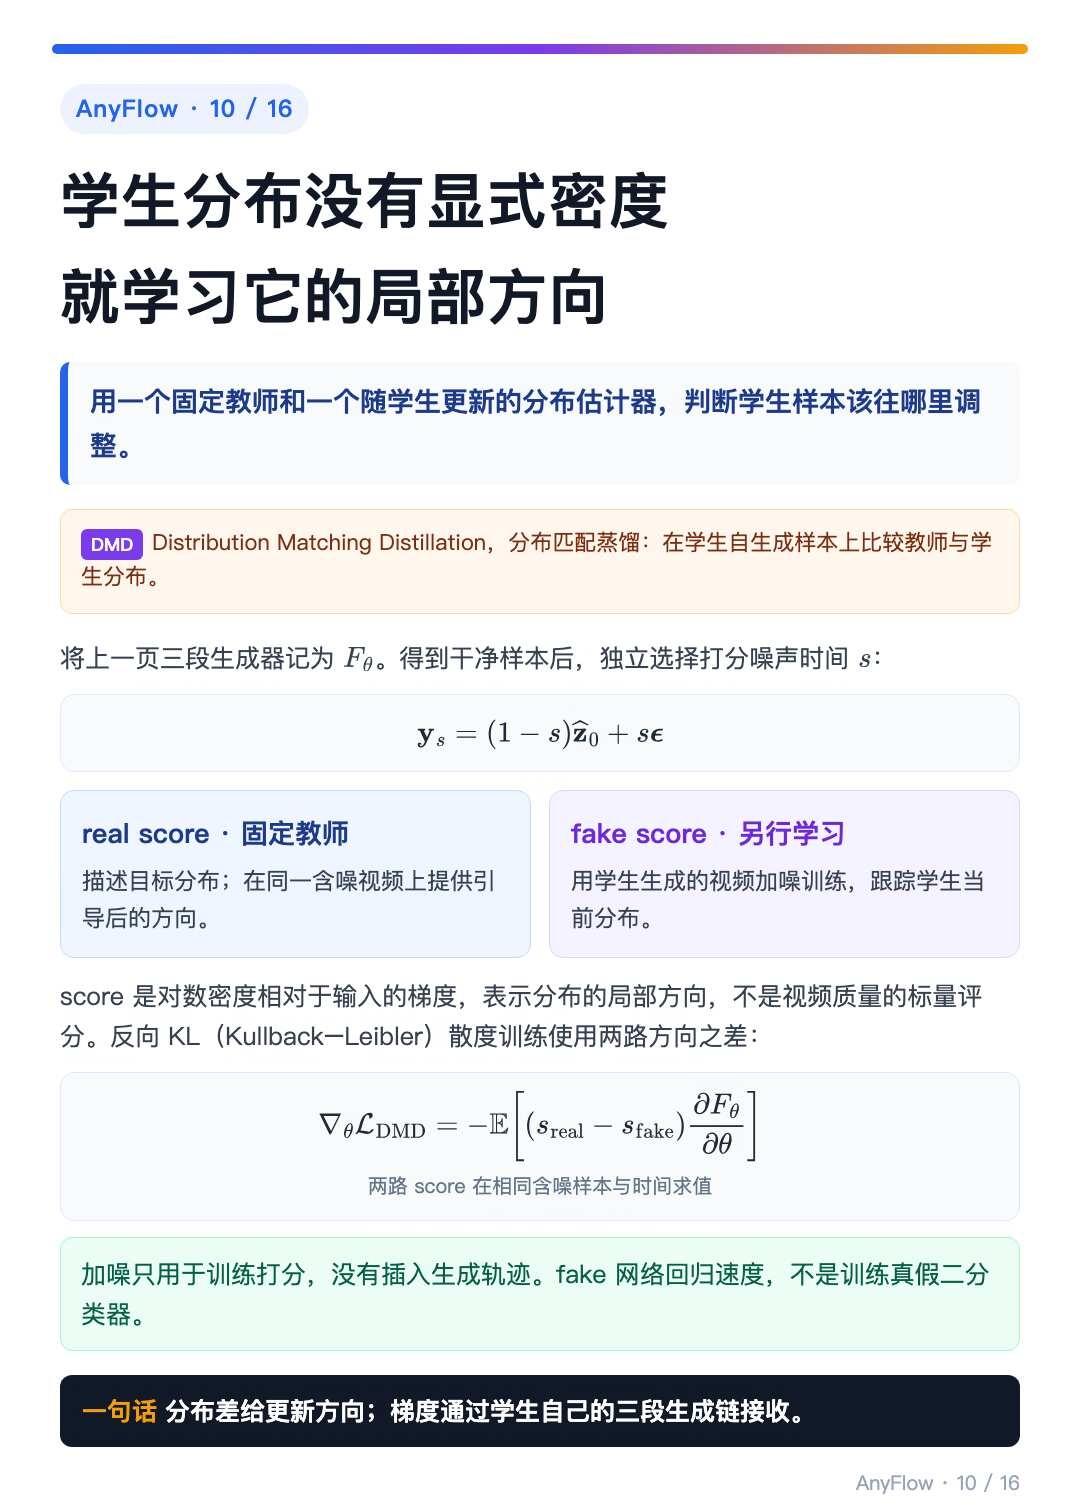
监督来自两个方向估计器:固定教师描述目标分布,另一个网络用学生样本学习学生分布。比较两者在同一加噪样本上的预测,再更新学生。
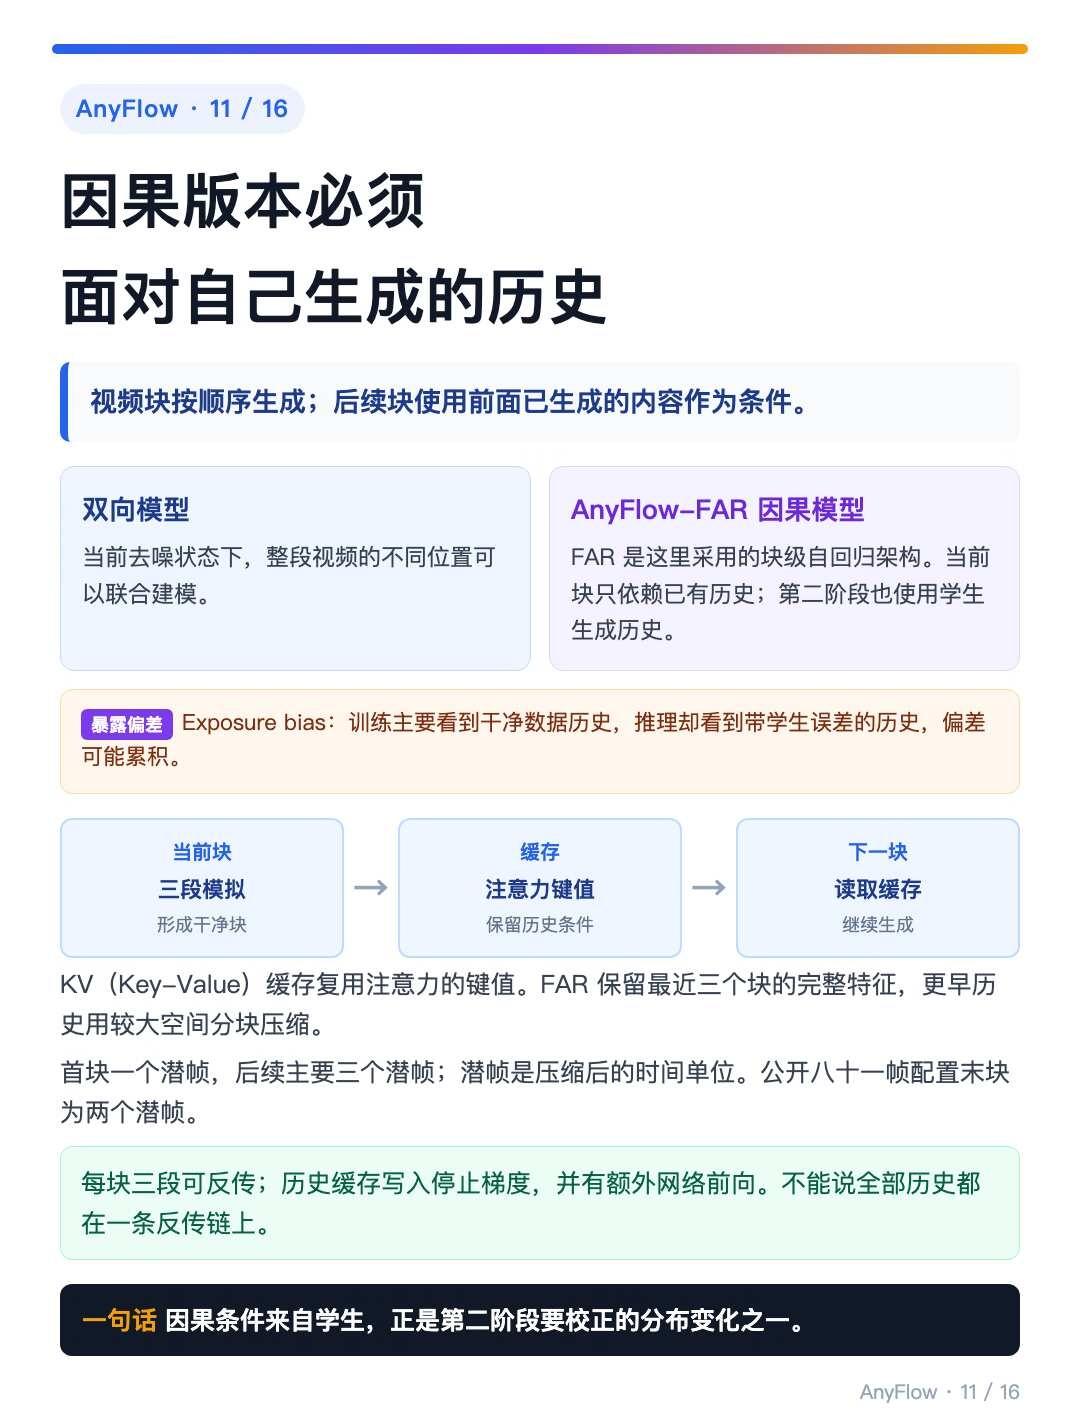
因果版本逐块生成并缓存历史。它在训练时也面对自己的生成历史;每块三段反传不等于通过全部历史缓存反传。
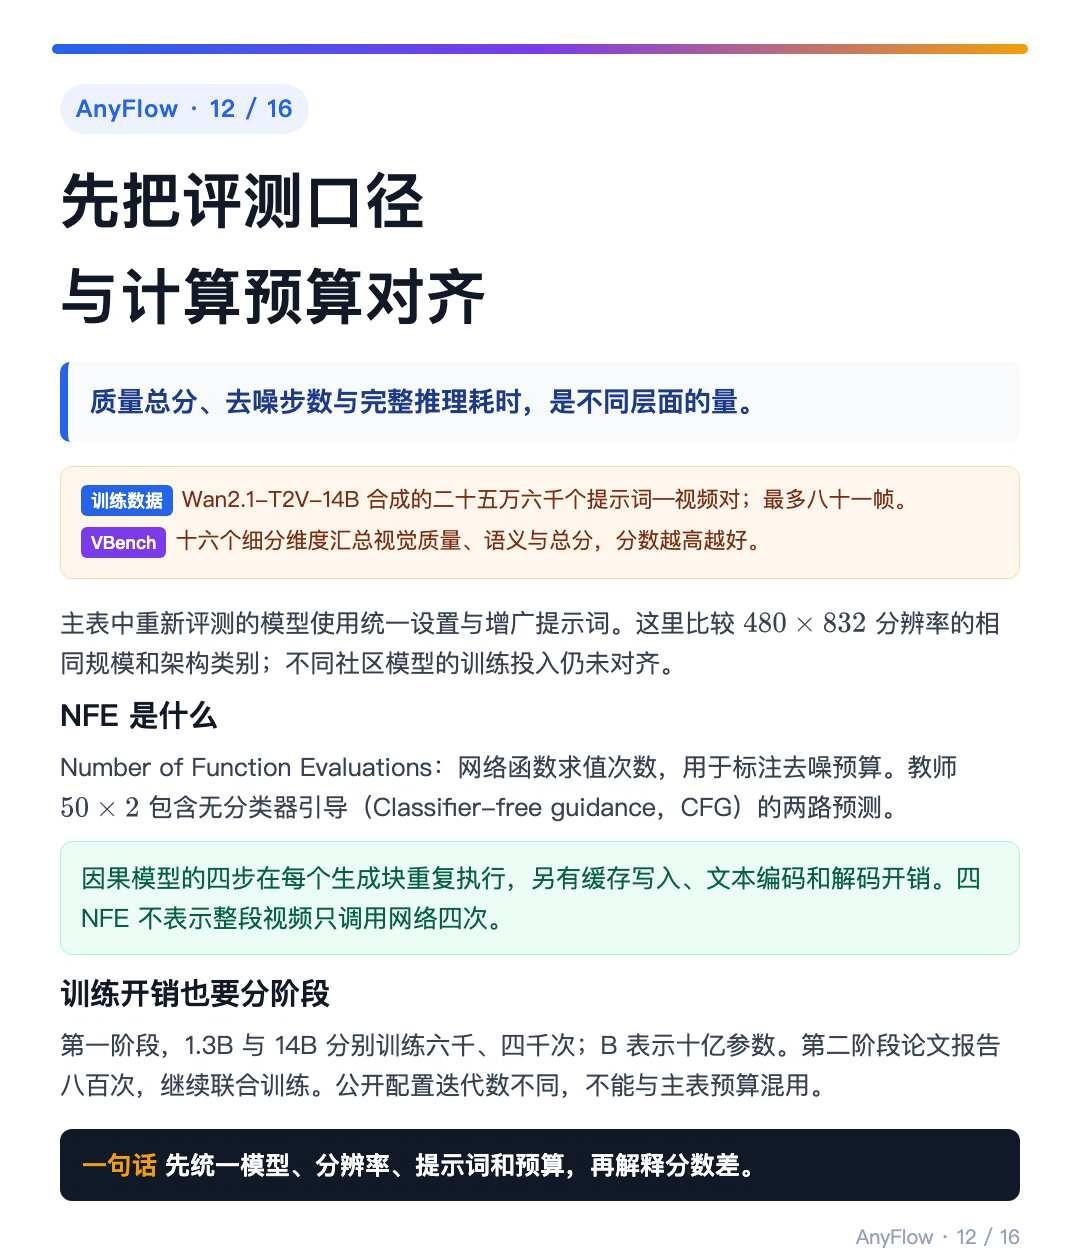
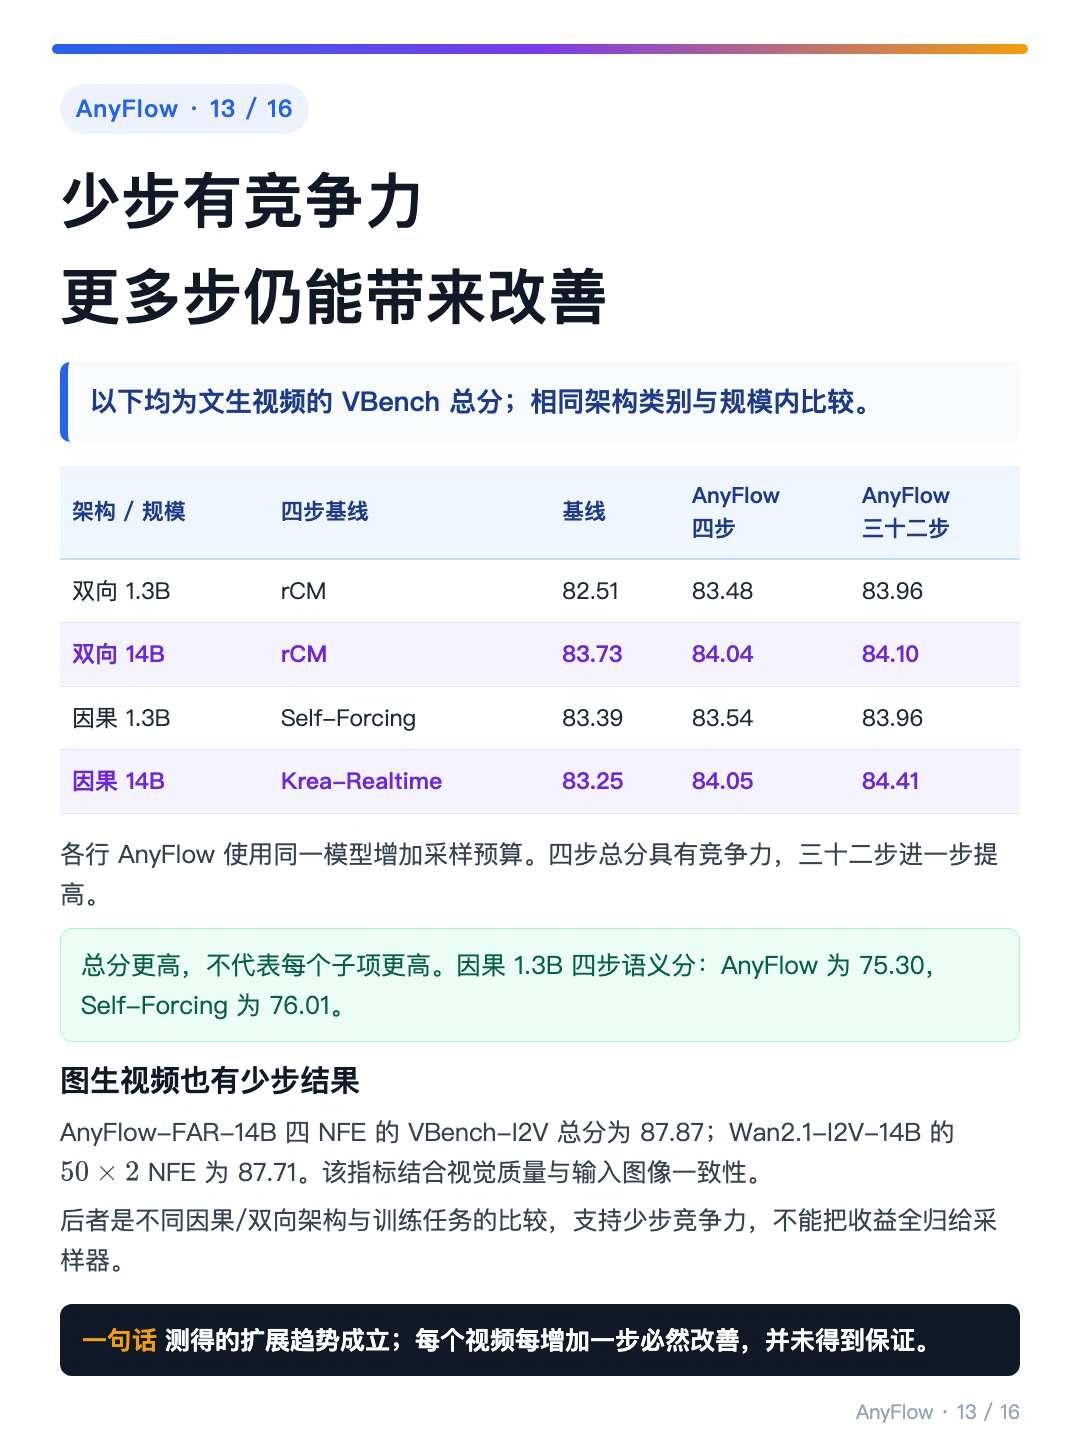
统一增广提示词评测中,14B双向四步VBench总分84.04,对照rCM为83.73;增到三十二步为84.10。14B因果版本四步84.05、三十二步84.41。总分越高越好,但子指标并非全部领先,也不保证每加一步必然改善。
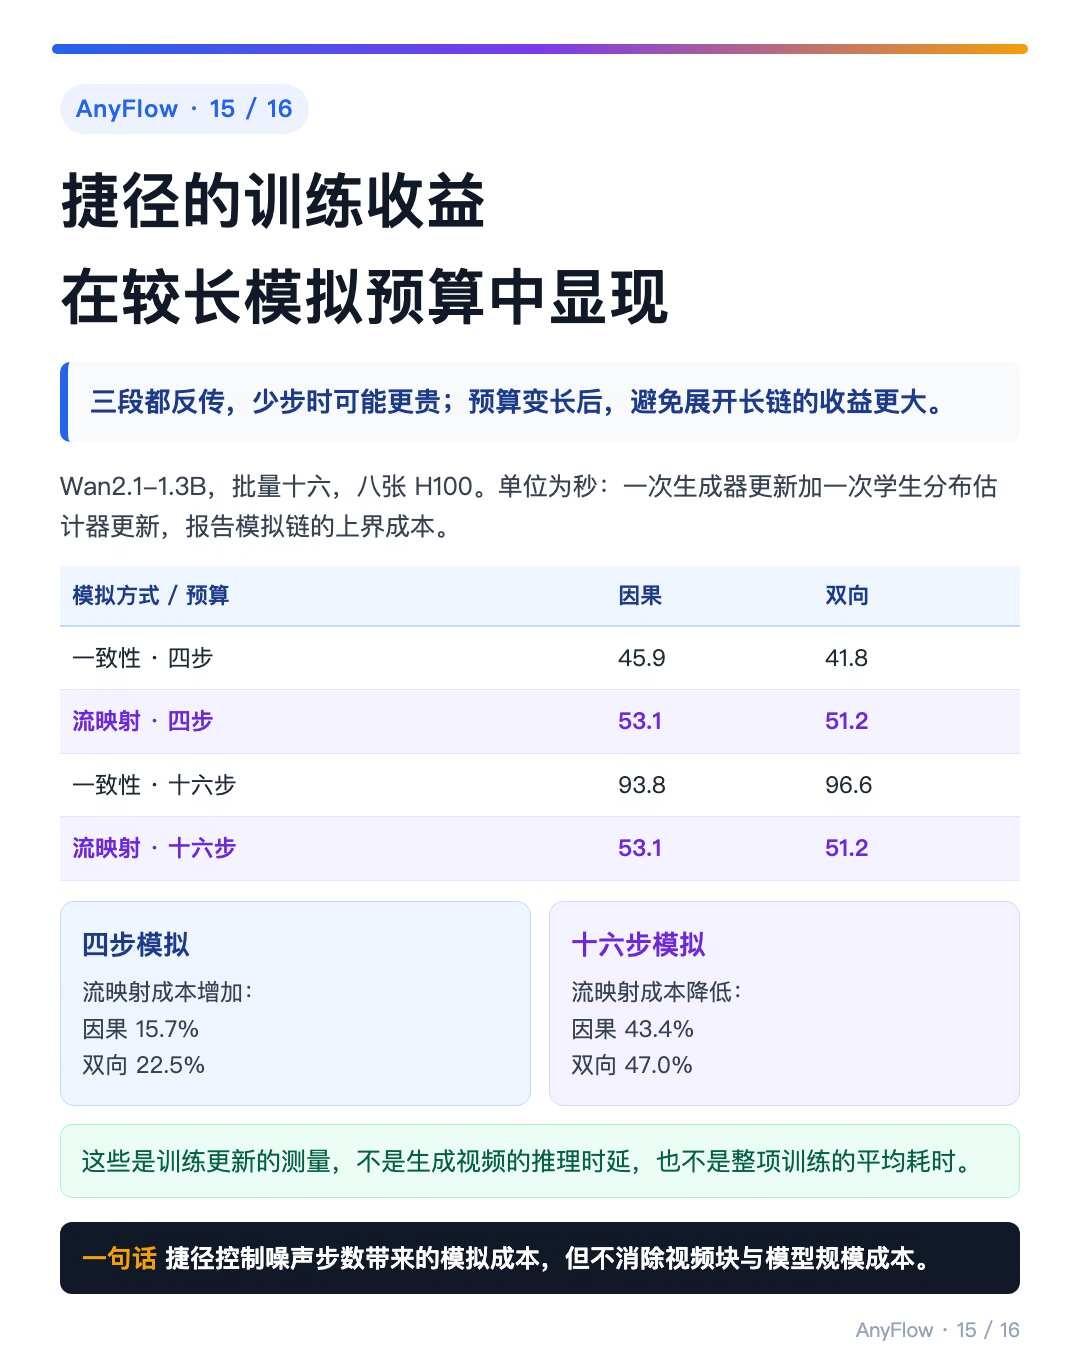
捷径模拟的成本优势主要出现在较大预算:八张H100、1.3B、批量16的十六步模拟对照中,因果训练更新成本降低43.4%;四步反而增加15.7%。这项成本包含生成器与分布估计器更新,不是推理时延。
世界模型 长视频生成 视频生成 人工智能 AIGC 计算机视觉 科研笔记 扩散模型 图像生成