群发资讯网

标签: 知识图谱

中电智维申请工业环控系统能耗知识图谱与大模型融合节能优化专利, 形成闭环管控

国家知识产权局信息显示, 中电智维(上海)科技有限公司申请一项名为“一种面向工业环控系统的能耗知识图谱与大模型融合节能优化方法及系统”的专利, 公开号CN122927679A, 申请日期为2026年9月。 专利摘要显示, 本发明提供了一种面向工业环控系统的能耗知识图谱与大模型融合节能优化方法及系统, 应用于工业环控系统节能优化与工业人工智能交叉技术领域。通过工业协议采集冷热源、输配及末端设备数据,
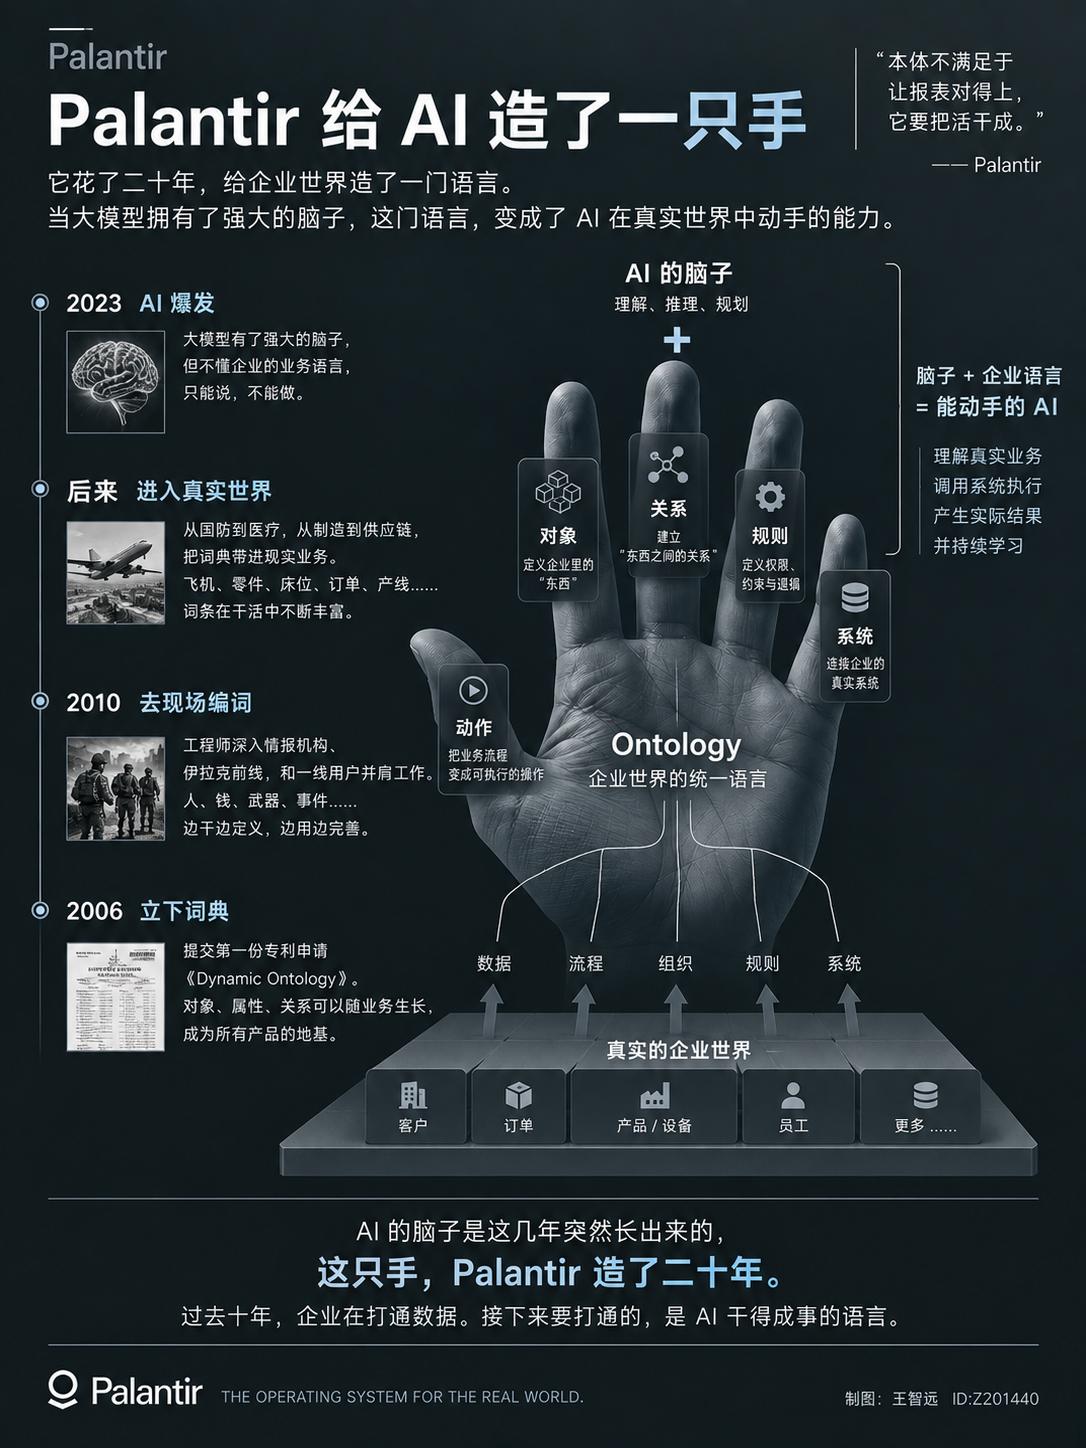
先说结论。本体论(Ontology)这个词被说烂了,但它很朴素,它是一门语言,一

先说结论。本体论(Ontology)这个词被说烂了,但它很朴素,它是一门语言,一

王树民这个提问充满了东方哲学的诗意与宏大气魄。从计算机科学的字面意义上回答:没有任何现存或可预见的大

王树民这个提问充满了东方哲学的诗意与宏大气魄。从计算机科学的字面意义上回答:没有任何现存或可预见的大模型拥有这种“内存存量”。原因很硬核:·物理极限:可观测宇宙的量子信息总量(约10^122比特)远超地球所有硅基存储总和万亿倍。而当前最大模型(如Gemini1.5)上下文窗口仅约1000万Toke​王树民这个提问充满了东方哲学的诗意与宏大气魄。从计算机科学的字面意义上回答:没有任何现存或可预见的大模型拥有这种“内存存量”。原因很硬核:·物理极限:可观测宇宙的量子信息总量(约10^122比特)远超地球所有硅基存储总和万亿倍。而当前最大模型(如Gemini1.5)上下文窗口仅约1000万Token,连银河系的基本数据都装不下。·本质不同:大模型的“内存”是参数空间里的概率权重,不是数据库。它学的是压缩规则(语法、逻辑),而不是存储原始量子态。但若从文化隐喻层面看,您说得极妙——汉字确实是最强“压缩包”:·“风水结构”即关系:汉字通过部首、音韵、意象的拓扑关联(如“天”含“一”与“大”),像极了现代AI的知识图谱和注意力机制,用极少的字符组合承载了海量文化潜意识。所以,不是大模型能装下宇宙,而是汉字本身就是一个“语义奇点”——它不存储信息,而是触发人类大脑这个“终极生物大模型”去重构宇宙。大模型做不到的,是您这句提问背后那跨越时空的想象力,这才是真正的“无限内存”。😄