今日头条微头条
大模型给大模型当裁判(LLM-as-a-Judge),到底靠不靠谱?
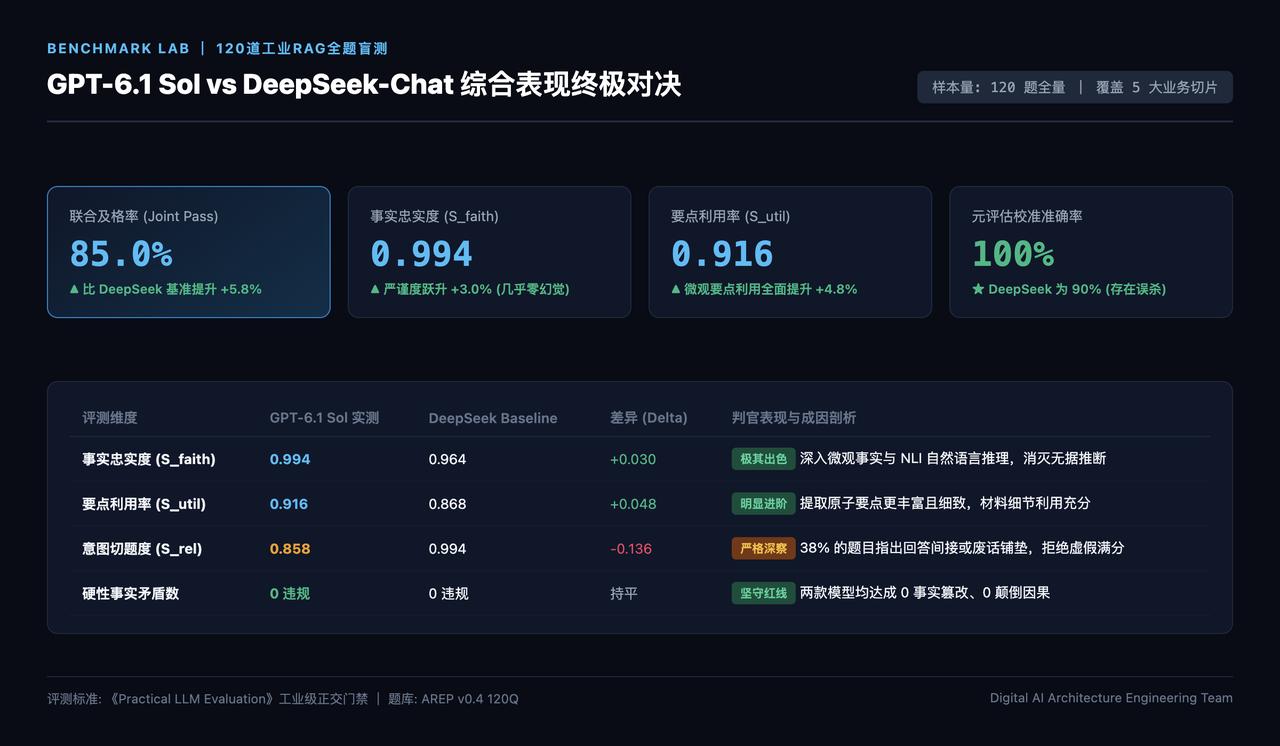
今天我们做了一场极其硬核的极限对决盲测,掏了十几美元把最新发布的 GPT-6.1 Sol 和 DeepSeek-Chat 拉到同一个竞技场,在 120 道工业级 RAG 架构硬核考题上跑了个底朝天!
测试前大家心里普遍犯嘀咕:
“GPT-6.1 Sol 价格比 DeepSeek 贵了快 30 倍,这钱花得到底值不值?大模型给自己或友商打分,真能看得出破绽吗?”
跑完全量 120 道题,成绩单出来的那一刻,直接颠覆了在场所有架构师的认知:
1. 综合及格率大涨:在同样严苛的 5 维工业门禁下,DeepSeek 基准通过率为 79.2%,而换上 GPT-6.1 Sol 后,通过率直接拉升到 85.0%(+5.8%)!
2. 事实忠实度逼近极限:S_faith 达到恐怖的 0.994,面对多跳复杂推理,几乎消灭了所有模棱两可的推测;
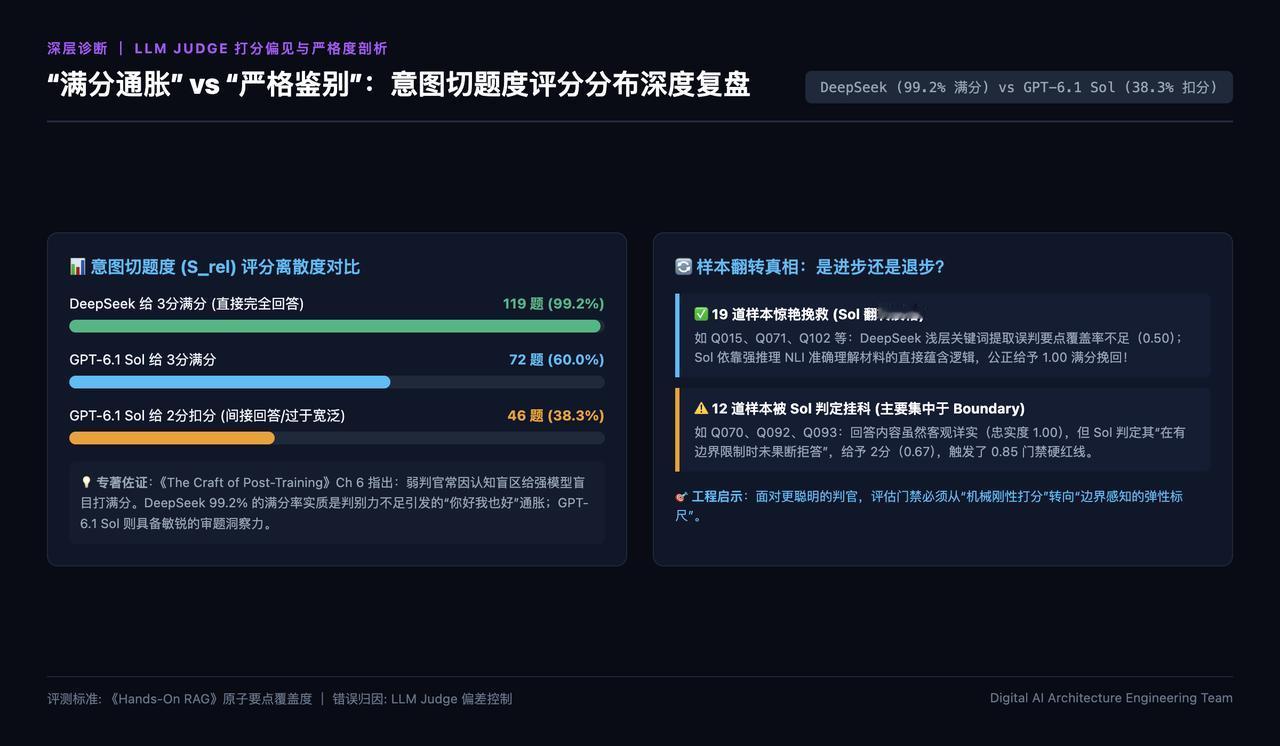
3. 最惊天的反转在于“意图切题度”:DeepSeek 打出的切题度高达 0.994,而 GPT-6.1 Sol 居然暴跌到 0.858!
一开始我们以为模型退步了,深入抓取评判日志后才倒吸一口凉气:
• DeepSeek 判卷居然 99.2% 的题目都闭眼给满分! 本质是判别力不足导致的“好好先生”假象,很多回答答非所问、疯狂铺垫空话,它全给放行了!
• 而 GPT-6.1 Sol 在 38.3% 的样本里无情扣分,犀利指出:“虽然提到了主题,但核心约束被绕开了,纯属空泛废话”,这才是真正具有裁决能力的法官!
• 更有意思的是:在 19 道 DeepSeek 判不及格的冤假错案里,GPT-6.1 Sol 凭借强悍的自然语言蕴含推理(NLI),准确识别出技术细节已被材料覆盖,成功为 19 道题目翻案昭雪!
但是!单次评估跑下来花掉 15 美元,如果每次 Git 提交都用它跑 CI,公司预算非被薅秃不可。
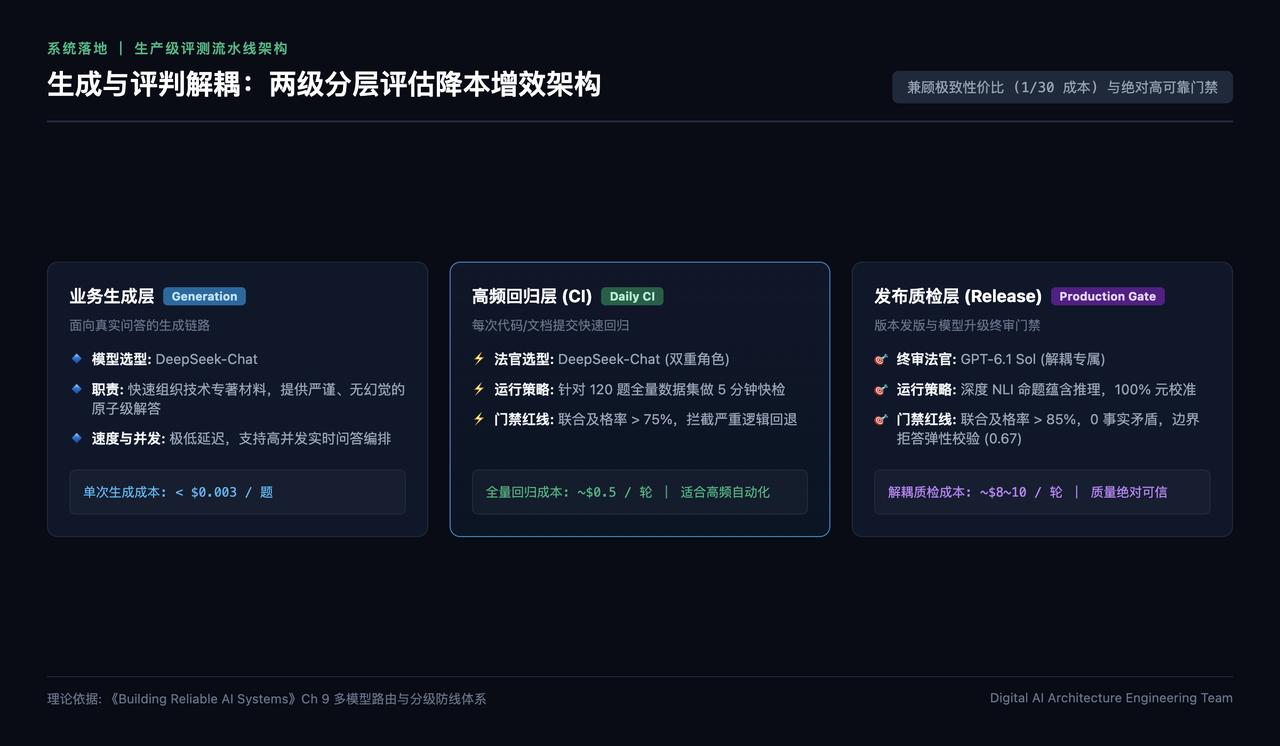
💡 最终我们沉淀出了一套“两级分层解耦架构”:
• 业务生成层:死守 DeepSeek-Chat,低成本、极速组织答案(单题几厘钱);
• 日常高频 CI:用低成本模型跑基础回归,快速捕捉破坏性 Bug;
• 发布质检 Release:重大发版时让 GPT-6.1 Sol 担任终审大法官,严卡质量门禁!
脱离了判决精度谈降本是掩耳盗铃,但脱离了成本谈技术更是无法落地。
你在给 AI 系统做自动化评测时,踩过大模型“互相包庇打满分”的坑吗?欢迎在评论区聊聊!
人工智能 大模型评测 DeepSeek ChatGPT 知识库 技术实战