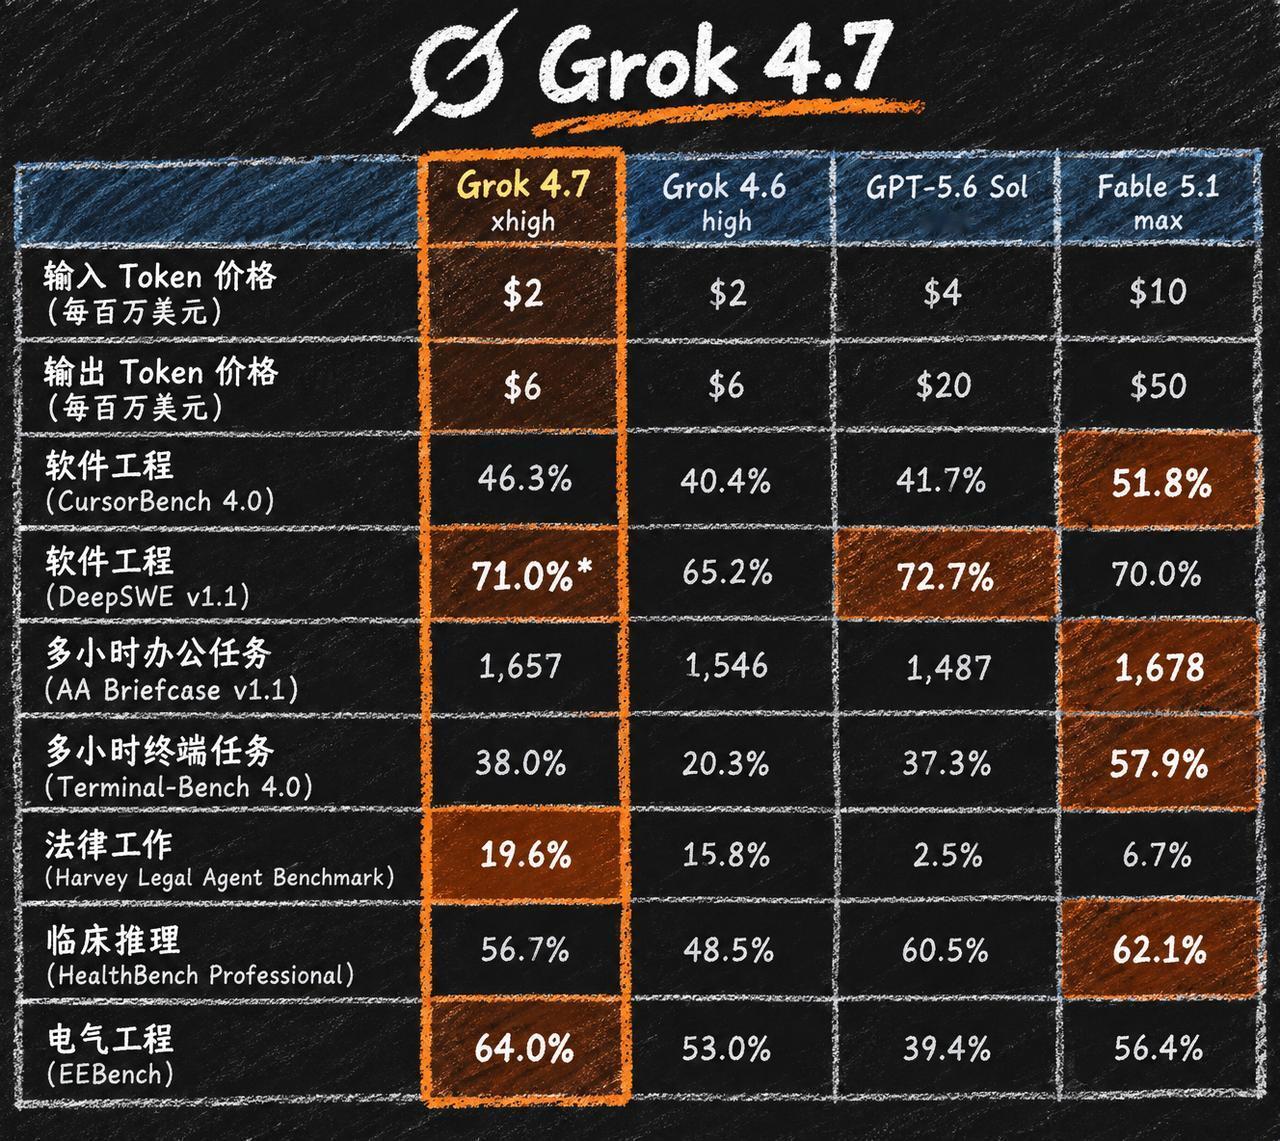
SpaceXAI 刚发布的 Grok 4.7,简直就是大模型界的暴力美学秀。
看一眼定价,Grok 4.7 依然坚守输入每百万 token 2美元、输出 6美元的白菜价。
反观友商,GPT-5.6 Sol 的输出要 20美元,Fable 5.1 更是高到 50美元。用 Grok 4.7 跑完一个大型工程分析,花掉的碎银子可能还不够在硅谷买半杯冰美式;而换成 Fable 5.1 跑一次,钱包直接被当场火化。
再看硬核指标,这模型的偏科倾向简直把马斯克本克焊死在了基因里。
在 EEBench 电气工程测试中,Grok 4.7 以 64.0% 的高分把 GPT-5.6 Sol 的 39.4% 碾得渣都不剩。毕竟是吃了大量 SpaceX 和 Starlink 真实工程数据长大的孩子,算电路、搞轨道、调硬件,分分钟教会文科生AI什么叫真正的硬核工业化。
最让人笑出声的是 Harvey 法务代理测试。GPT-5.6 Sol 在这个项目上只拿到了惨绝人寰的 2.5%,而 Grok 4.7 竟然飙到了 19.6%。
这不得不让人怀疑,马斯克是不是把自己这些年打官司的所有卷宗都喂给了它。搞工程它能算火箭推力,搞诉讼它能帮你跟合规部门大战三百回合。
至于程序员们最关心的打工能力,Terminal-Bench 终端任务得分从 4.6 版的 20.3% 直接暴涨到 38.0%。配合 DeepSWE 的 71.0% 和 CursorBench 的 46.3%,这意味着它不再是那种写两句代码就脑干缺失、半路撂挑子的实习生,而是一个能自己检错、连轴转几个小时都不嫌累的数字牛马。
马斯克嘴上说着质量优先,手里的价格战大棒却挥得比谁都凶。
在大模型同质化越来越严重的今天,Grok 4.7 走出了一条极具讽刺意味的路:高高在上的哲学AI,打不过能修火箭、能打官司、还收费便宜的工程实干家。今晚的硅谷,恐怕又有一批大模型高管要盯着这份数据图默默把简历改好了。